智能体工作流
TensorSharp.AgentHost 把本地模型的一次回复变成有界的生成 → 检查 → 运行 → 修复 → 回答循环。它只在需要时加载 Agent Skills(智能体技能),通过四个内置代码工具处理文件,在操作系统沙箱中运行检查,把服务端请求中相互独立的部分交给有界子智能体,并向普通 CLI、Web UI、Ollama 或 OpenAI 客户端返回完成的产物。
一轮请求里发生什么
低成本公布能力
TensorSharp 在提示词里只放入每个可达技能的名称与描述。选中技能只表示优先使用并允许访问,不会加载其说明正文。
按需加载说明
支持工具往返的模型判断某项技能适用时,会调用
skills_read(skill, "SKILL.md")。TensorSharp 在进程内应答这个内置调用,把结果加入同一段对话,再次生成。完成实际工作
若运维方启用了
--code-exec,模型便可在请求或聊天工作区中检查、编辑、新建、打补丁并测试文件。技能脚本也能参与,但必须单独选择允许执行。返回普通答案
客户端收到最终完成结果,而不是 TensorSharp 内部工具调用。调用方自带的工具绝不会由 TensorSharp 执行;这些调用仍会正常返回给调用方处理。
同一个已加载模型、进程内工具,以及有界子智能体。在服务端聊天路径上,支持工具的模型还可以把独立的工作委派给运行在同一个已加载模型上的子智能体;CLI 只运行单个智能体。每条命令执行前没有交互式审批队列。运维方在 CLI 或服务器启动时授予或拒绝技能、脚本执行、代码执行、联网与安装能力;之后内置工具只能按该策略运行,否则拒绝。
TensorAgent:一个应用,多种工作
TensorAgent 是基于 TensorSharp 引擎、聊天流水线与 AgentHost 的本地 .NET MAUI 应用,面向 iPhone/iPad、Mac Catalyst 与 Windows WinUI。macOS 和 Windows 发行包的使用方式见桌面下载、安装与使用指南;iPhone/iPad 仍通过源码构建。CLI/服务端归档和 NuGet 包不会安装该应用。
| 工作类型 | 应用提供的能力 |
|---|---|
| 文本与多模态聊天 | 使用支持的文本模型进行本地问答、推理与工具调用;照片、视频、音频和文件支持取决于所加载模型。 |
| 个人知识库 | 导入文件、嵌套文件夹和已保存聊天,按聊天选择集合,检索带位置的证据并打开保留原文件。文档提取、PDF OCR、媒体派生文本与可选语义检索各有覆盖限制。知识库指南 → |
| 图像生成与编辑 | Qwen-Image 2.1 按描述生成图像,结合可选参考图编辑一张照片,并支持涂选区域、保留区域外像素。可比较结果或再次编辑;基础版提供十四个 LoRA 插件,其中四个为加速适配器。Turbo 有固定 8 步配方,仅提供兼容风格/编辑插件;AD-Q4_K 与基础版为 24 GB 档位,Turbo Q8_0 为 32 GB。 |
| 带声音的视频 | MiniMax-H3 根据文字、关键帧或参考素材生成短片与配乐;TensorAgent 的 Apple 媒体实现将音频写入 MP4。其关键帧条目提供两个可选的提速插件:LightX2V Turbo 8-Step 与 4-Step(各 1.38 GB),在聊天与 Studio 中按片段应用;4 步调度为推断所得,应用内尚无使用它们的耗时记录。目录要求 32 GB 内存档位。Windows 音视频生成尚未验证。 |
| 文件、代码与浏览器工作 | 技能、工作区文件工具、命令执行与有界子智能体可创建供下载的产物。桌面版包含 Playwright 浏览器技能。iOS 使用嵌入运行时,不能启动浏览器进程;桌面命令和网络访问遵循 Sandbox 设置。 |
界面、原生页面及分享扩展支持英语、简体中文、繁体中文、日语、韩语、西班牙语、法语与德语。设置 → 语言可覆盖系统语言。这会改变界面语言;模型能理解和生成的语言由所加载模型决定。
使用硬件键盘时按 Enter 发送,Shift+Enter 换行。完成的文本轮次显示 token 数、耗时和吞吐;图像与视频轮次显示去噪进度。
生成时可以发送新指令引导回答:当前生成中断,已产生的回答保留,新指令在清理完成后继续。知识库与回答引导需要 v2026.10.10 后的构建。使用说明 →
iPhone 与 iPad 上的 TensorAgent
TensorAgent 将本地聊天与智能体体验打包为 .NET MAUI iOS/iPadOS 应用。引擎以 iOS .xcframework 静态链接,在真机上使用 ggml_metal,真机上的备选后端是 ggml_cpu,模拟器上也只有 ggml_cpu;iOS 端不构建 MLX。应用与服务端共享与宿主无关的聊天流水线(TensorSharp.Chat);由于 iOS 没有 ASP.NET Core runtime pack,UI 通过进程内 loopback server 提供。共享的是 API 而不是页面:手机上是它自己的页面,按拇指而不是鼠标与宽窗口来排布,但绑定同一套 WebUiChatService 与 SkillsService 路由。
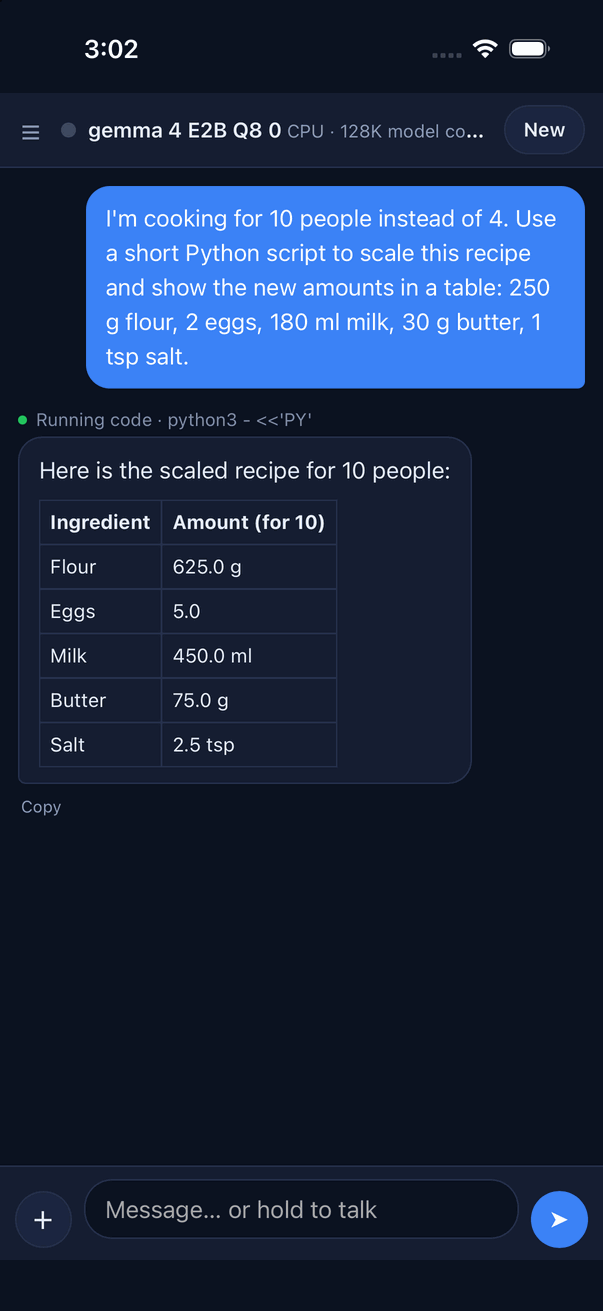
ggml_cpu;在 iPhone 真机上使用 ggml_metal。模型写了一个简短的脚本,在应用内置的 Python 中运行,并以表格作答。模型支持断点续传与 SHA-256 校验并下载到设备;会话可跨应用重启保留;照片、相机、视频、文件和听写使用同一套聊天附件流程。由于 iOS 不能启动子进程,TensorAgent 的 shell、Python 与 JavaScript 集成由运行时提供,并明确报告能力边界。
手机相对桌面多出三条约束,以及应用对每一条的处理:
| 约束 | 应用的处理 |
|---|---|
| 回答过程中屏幕被切走 | 生成过程归宿主侧的管理器所有,而不属于 WebView——视图离开窗口后 WebKit 会挂起该页面。在应用内切换到其他页面时,这一轮继续生成。应用离开前台时,由于 iOS 禁止后台 GPU 工作,引擎会在步与步之间暂停;这一轮保留自己的进度与缓存,应用回到前台后继续生成,页面也会重新挂接上去。 |
| 每次启动的第一条消息都要为整段共享前缀买单 | 所有会话共享的那段提示词末尾的状态,会按模型持久化到磁盘,并在下次启动时于准入阶段恢复。在 iPhone 17 Pro Max 上以 Qwen3.5 9B 实测:原本 54 秒的冷启动首条消息,变成 1.2 秒预热加约 0.6 秒的首条消息。 |
| iOS jetsam 杀进程时既无栈也无消息 | 引擎的内存策略按 jetsam 实际计费的口径设定——被 wire 住的文件页算在设备头上而不是进程头上——因此缓存从小起步按需增长,单个请求只预留有界的回复长度,收到内存警告时释放那些只为下一次请求提速的部分。 |
应用面向 iPhone 与 iPad(arm64,iOS 17.0 及以上)。它采用 scene 生命周期——用 iOS 27 SDK 构建时必须如此才能启动;已记录的真机运行均在 iOS 26.6.1 上。内置模型目录——Gemma 4 E2B、E4B 与 12B、Qwen3.5 9B——向 12 GB 及以上内存档位的设备提供;标为实验性的 Bonsai 2 27B 需要 16 GB 档位(iPad 与 Mac)。以下几点与桌面宿主不同:
- 推测解码默认开启——Gemma 4 E4B 与 12B 在已下载草稿头时使用草稿头,否则在模型支持推测解码时使用 n-gram 查找。修改该设置会从下一条回复起作用于正在运行的引擎。
- 子智能体委派默认开启,并有开关(见下文)。设置 > Sandbox >“Sub-agents”可从下一条消息起关闭它,像
--no-multi-agent一样不再声明协调工具;上限保持宿主默认值,手机页面也不显示子智能体面板。 - 生成的文件用 Quick Look 打开,无法预览时回退到分享面板。
- “Ask TensorAgent” 分享扩展可把其他应用中的网页、照片、文件或文本带进聊天,并提供 Summarize、Key points、Translate 等预设。
同一个 AgentAppHost 也能运行在 macOS、Linux 与 Windows 上。在这些平台上,AgentExecutionMode.Auto(或 Process)会以原生进程、在桌面 OS 沙箱中运行命令与技能脚本,而不是使用内嵌运行时。设置了 networkHosts 白名单时,这一桌面后端会拒绝需要联网的启动,而不是放宽它无法强制执行的访问范围。
Mac 与 Windows 上的 TensorAgent
macOS 安装 · Windows 安装 · 选择第一个模型 · 配置代码与浏览器工具
同一个项目构建 Mac Catalyst 与 Windows WinUI 桌面 TensorAgent,共享页面、会话、技能与可搜索的模型家族目录。当前目录共 39 个条目,包含较大的 Gemma/Qwen、Muse-Glimmer、GPT OSS、Nemotron、Mistral、Hunyuan、DiffusionGemma、DeepSeek 与 GLM,以及 Qwen-Image 2.1/Turbo、LTX 2.5 Distilled 和两个 MiniMax-H3 检查点。系统内存档位决定是否可加载,新增条目大多仍为实验性;元数据、哈希与容量检查不能证明所有模型/设备推理通过。Qwen-Image 2.1 Turbo 提供 AD-Q4_K(24 GB)与 Q8_0(32 GB)两种固定 8 步条目。Qwen3.8 Flash Next 提供 48 GB 的 UD-Q2_K_XL 和实验性 32 GB UD-IQ1_M 条目,使用映射 n-gram/专家权重按需读取;实际性能取决于内存、GPU 与 SSD。
桌面使用 GgmlOps(Mac 为 ggml_metal,Windows 按构建/设备能力选择后端)。代码与浏览器技能运行真实进程;Mac 使用 Seatbelt,Windows 需启用不使用沙箱运行。后台窗口中的生成继续运行,工作期间阻止 App Nap 与闲置睡眠。缓存按目录预算分配,lean-cache 条目采用保守分配;较早一次 Qwen3.8 27B 测量中,应用内存从 18.8 GB 降到 8.8 GB。在 M5 Pro / Gemma 4 E2B 上,Mac 应用的解码速度与同一份 CoreCLR 宿主代码相差不到 3%,首 token 约晚 60 毫秒;这是特定模型/设备的测量。2026-10-01 的 Windows x64 / RTX 3080 Laptop Debug 与 Release 检查覆盖特定聊天、文件、代码、合成视觉、取消与恢复,不覆盖目录下载、原生选择器、音视频生成、所有模型/后端或长时间运行。确切记录见 TensorAgent README。
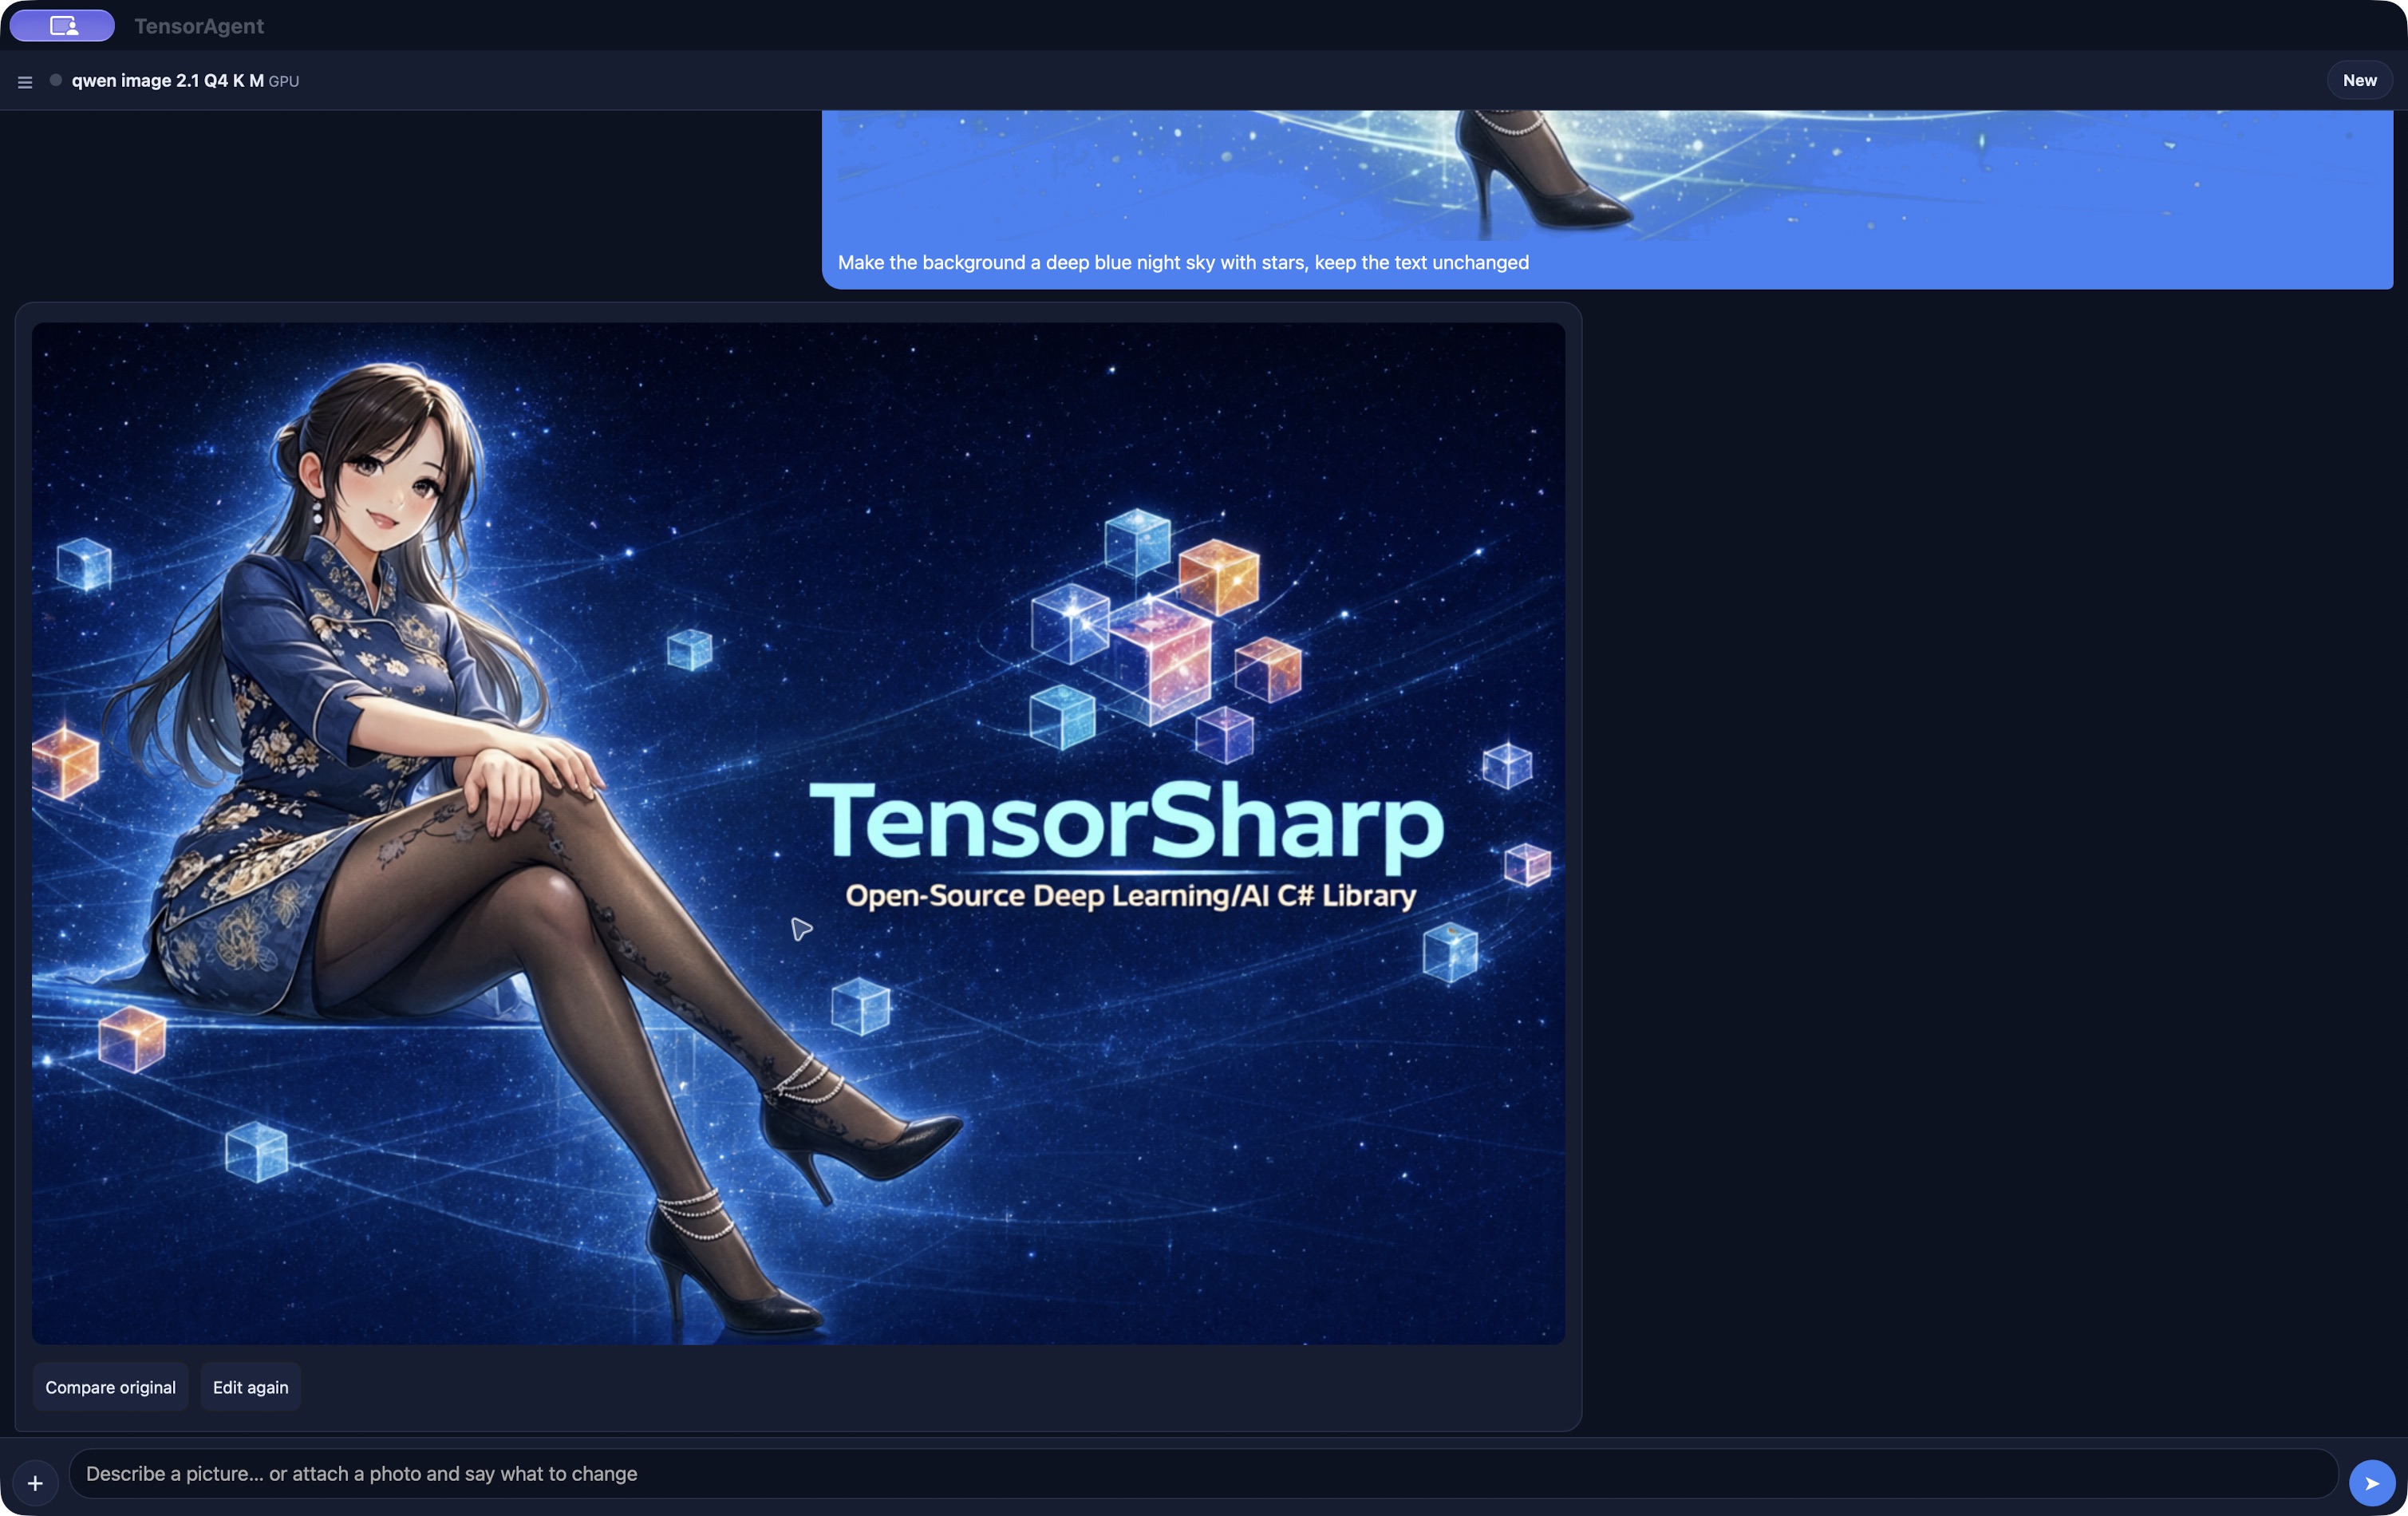
ggml_metal,机器为 48 GB 内存的 Apple M5 Pro。保存的图像编辑会话将横幅背景改为深蓝色星空并保留文字;比较原图和再次编辑可查看与继续编辑。截图于 2026-10-02 从当前 Release 应用捕获,不是一次新的推理计时测量。构建、模拟器、真机、桌面版与验证步骤见 TensorAgent README。
Agent Skills 与渐进式披露
一个技能就是一个目录:必需的 SKILL.md,加上说明会用到的脚本、参考资料与素材。TensorSharp 遵循 Agent Skills 规范,可直接加载公开技能仓库,无需改写其目录布局。
pdf/
├── SKILL.md
├── scripts/
│   └── extract_tables.py
├── references/
│   └── forms.md
└── assets/
└── template.pdf| 层级 | 模型会看到什么 | 何时看到 |
|---|---|---|
| 元数据 | name + description | 选中技能与可发现技能都会预先给出;这就是正常路径的提示词成本。 |
| 说明 | 完整的 SKILL.md 正文 | 仅当模型通过 skills_read(skill, "SKILL.md") 激活该技能之后。 |
| 随包文件 | 参考资料、脚本与素材 | 只索引路径和大小;内容由 skills_read 按 48 KB 分页读取。 |
正常元数据块约使用上下文窗口的 2%,并限制在大约 1,024–10,000 token。旧版“把所有选中技能正文预先内联”的行为默认关闭。无法携带并解析工具声明的模型家族没有机会调用 skills_read,因此 TensorSharp 会在有界回退预算内直接内联所选技能正文,同时不再宣传根本无法加载的技能。
基础技能工具是 skills_list 与 skills_read。传入 --skills-allow-exec 后还会提供 skills_run;原生发现/安装工具有单独条件,见下文。技能脚本默认不允许运行,并且始终与模型生成代码的执行权限分开控制。
技能从哪里来
--skills-dir(可重复)或 TS_SKILLS_DIR 显式指定技能根目录。两者都未给出时,CLI 与服务端会从当前工作目录向上直到 Git 仓库根目录,依次查找每个已存在的 .agents/skills 目录(离得最近的优先;不在仓库内时只检查当前工作目录),另外还有二进制文件旁边的 skills 目录(不存在时自动创建)。CLI 最后才查找这个目录。在服务端,它同时是上传目录,因此总会被扫描,而且最先扫描:同名时上传的技能优先;即使用 --skills-dir 或 TS_SKILLS_DIR 替换了 .agents/skills 默认根,它也仍在列表中。个人或全局技能目录绝不会被隐式导入。
发现、检查并安装社区技能
内置 find-skills 使用共享 .NET 工具搜索 skills.sh、检查公开 GitHub 包,并安装检查过的固定提交;发现/安装不需要 Node、Git 或子进程。TensorAgent 开启 Network,服务端设置 --skills-allow-network;当前请求还必须能访问 find-skills。显式空技能选择会关闭这些工具。
| 工具 | 行为 |
|---|---|
skills_search(query, owner?) | 返回包标识、来源、链接与安装次数;安装次数不证明质量。 |
skills_inspect(package) | 获取固定提交的说明、兼容性、许可与文件清单,不执行仓库代码。 |
skills_install(package, revision?) | 仅安装同请求检查过的提交,不覆盖同名技能;需要宿主的可写安装目录。 |
包名使用 owner/repository@manifest-name。服务端与 TensorAgent 配置可写注册表;CLI 默认只读,提供搜索/检查。安装请求立即获得新技能,其他活跃请求保留原范围;后续请求再通过普通发现获得它。安装本身不授予代码/脚本执行权限,外部依赖仍可能不可用。
当前共享包共 17 个,新增 find-skills、grill-me、grill-with-docs、tdd 与 handoff。静态兼容性检查判定 15 个适合进程内移动宿主;playwright 与 web-artifacts-builder 不进入移动目录。静态判定与成功安装都不是模型任务质量证明:Gemma 4 E4B Q8 的受控 macOS Metal 工作流为 3/4 完整任务通过,一个 HTML 按钮语义失败;没有原生 GUI、Windows 或真实 iOS 的全工作流结论。协议、审计来源与验证限制 →
四个代码工具,默认关闭
--code-exec 会加入一套补丁优先的代码工作面。它不要求安装技能;仅安装或选中技能也不会自动开启它。
| 工具 | 用途 | 关键边界 |
|---|---|---|
read_file | 按行号读取工作区中的真实字节。 | 输出有界;路径必须留在工作区内。 |
write_file | 新建文件。 | 限制在工作区内;路径已存在时会被拒绝,已有文件通过 apply_patch 修改。 |
apply_patch | 通过带锚点的 hunk 修改单个或多个文件,包括单行修改;也支持新建、重命名与删除文件。 | 原子操作:全部 hunk 成功,否则一个也不落地。 |
shell | 运行测试、命令与生成的程序。 | 有超时与输出上限;受支持主机上必须沙箱化,否则拒绝。 |
失败结果专门为后续修复而设计。若诊断定位到工作区内的常规源文件,结果会附上有界的源码片段,并要求先用 apply_patch 做最小修改再重新运行。语法检查、允许时自动补齐缺失依赖、以及从已安装库中探测真实 API,都能减少无意义的模型轮次。
工作区生命周期与产物
| 入口 | 工作区生命周期 | 结果 |
|---|---|---|
| CLI / 交互聊天 | 在进程或聊天会话期间持续存在。 | 后续工具调用能检查或修复先前调用写下的文件。 |
| 内置 Web UI | 在该 Web 聊天会话期间持续存在。 | 显示实时的编写 / 运行状态、有界输出与生成文件下载标签。 |
| OpenAI 与 Ollama HTTP 聊天 | 一次请求的所有内部工具轮次共享一个私有工作区;响应结束即删除。 | 同一请求内可以反复修复,而不同请求保持无状态。 |
未开启代码执行时的 skills_run | 每次调用使用新的临时目录,返回后删除。 | 脚本不会意外共享状态。 |
开启代码执行后,技能脚本会与四个代码工具共享同一个请求 / 聊天工作区。服务端会把生成的文件复制到有界产物存储中;Web UI 提供安全下载链接,产物响应始终作为附件发送并禁用内容嗅探。
“沙箱化,否则拒绝”的安全模型
是否允许执行由运维方决定,不是请求字段。在 macOS 与 Linux 上,模型生成命令和已获准的技能脚本默认具有工作区写入边界、不可读的用户主目录、清理后的环境变量,并且不可联网。进入操作系统沙箱之前,进程内还会再次检查路径。
| 平台 | 模型生成代码 | 技能脚本 |
|---|---|---|
| macOS | 使用 sandbox-exec;无法提供隔离时拒绝运行。 | 默认 --skills-sandbox required;要么沙箱运行,要么拒绝。 |
| Linux | 要求 bwrap 0.12.0 或更高版本;否则拒绝。 | 默认 required 模式下同样要求安全版本的 bwrap。 |
| Windows | 尚未实现文件系统 / 网络沙箱。必须显式传入 --code-exec-unconfined,这会有意授予该进程可及的文件与网络范围。 | 作业对象只能约束进程树,不能限制文件和套接字。默认 required 会拒绝;--skills-sandbox preferred 是明确接受较弱隔离的选择。 |
沙箱并不等于一次性虚拟机。macOS 为兼容性有意保留对共享 /private/tmp 与每用户 Darwin 临时目录的访问,以及部分本地 Unix IPC。Seatbelt 限制会传递给子进程,普通进程组也会被停止,但有意脱离的子进程可能活过本次请求;每次工具结果都会报告这一缺口。Linux 即使禁止 IP 网络,也仍共享宿主网络命名空间的某些部分。每项平台缺口都必须认真对待。不要在他人可访问的服务器上启用非受限执行。
网络与软件包安装是彼此独立的授权
| 选项 | 默认 | 授予什么 |
|---|---|---|
--code-exec-allow-network | 关闭 | 让所有模型生成命令使用不受域名过滤的宿主 IP 网络,包括 LAN / loopback 服务。 |
--skills-allow-network | 关闭 | 只为已经获准执行的技能脚本开放网络;不会影响 shell。 |
--code-exec-allow-install | 关闭 | 允许宿主代为执行可识别的 pip / npm 安装。宿主读取并校验包名,只用预构建 wheel / 禁用 npm 脚本,并从模型命令中移除安装部分。 |
--code-exec-packages、--code-exec-install-index 与 --code-exec-install-domains 约束的是宿主安装器。一旦开放模型命令的无限制网络,它们就不再是安全边界,因为生成代码可以直接下载产物。技能脚本与代码工具的网络开关有意彼此独立。
浏览器自动化:Playwright 技能
浏览器“computer use”是一个技能,而不是运行时功能:没有屏幕或鼠标工具,也没有浏览器桥接。TensorAgent/skills 中的 playwright 技能包通过 skills_run 和一个包装脚本驱动真实浏览器,该脚本用 npx 运行固定版本的 @playwright/cli。它的说明涵盖导航、填写表单、快照、截图与数据提取,在信息缺失时向用户询问,以及遇到登录或 CAPTCHA 时把有界面的持久化浏览器交给用户处理。
dotnet run --project TensorSharp.Server.Host -c Release -- \
  --model models/model.gguf --backend ggml_metal --host 127.0.0.1 \
  --skills-dir ./TensorAgent/skills \
  --skills-allow-exec --skills-allow-network \
  --code-exec --code-exec-allow-install --code-exec-allow-network
除这些授权外,宿主上还需要真实的 Node.js、npm 与 npx。在 macOS 上,技能会让模型用 write_file 创建 .playwright/cli.config.json 来关闭 Chromium 自己的沙箱,因为已被 Seatbelt 约束的进程无法再启动第二层沙箱;外层 Seatbelt 沙箱仍然开启。已记录的模型驱动工作流运行于 macOS arm64。Windows 另有针对本地合成登录页的真实技能运行器探针,检查原生 Node 包装、浏览器/会话生命周期与清理;这种有界集成不构成真实站点认证或模型驱动成功的验证。Linux 浏览器工作流尚未验证。iOS 应用包不包含它,因为 iOS 没有子进程,也没有 Node.js;TensorAgent/skills 仍为桌面宿主保留它。配置、账号交接与实测记录见 docs/playwright_agent.md。
启动一个智能体会话
使用技能并不要求执行代码:
dotnet run --project TensorSharp.Cli -c Release -- \
  --model models/model.gguf --backend ggml_metal \
  --skills-dir ./skills --skill pdf -i
显式加入四个代码工具。下例仍然关闭命令网络与软件包安装:
dotnet run --project TensorSharp.Cli -c Release -- \
  --model models/model.gguf --backend ggml_metal \
  --skills-dir ./skills --skill pdf --code-exec -i
也可以为 Web UI 与兼容 API 托管同一套循环:
dotnet run --project TensorSharp.Server.Host -c Release -- \
  --model models/model.gguf --backend ggml_cuda \
  --skills-dir ./skills --code-exec

# 浏览器 UI:http://localhost:5000/
# 存活检查:  http://localhost:5000/health
Linux 请先安装 bwrap 0.12.0 或更高版本。在 Windows 上,除非运维方有意加入 --code-exec-unconfined,否则代码执行不可用。不要把这个 Windows 逃生开关复制到共享服务器上。
从普通 HTTP 客户端使用技能
服务器启动时必须配置技能注册表。客户端随后在普通聊天请求上选择技能;TensorSharp 在内部处理自己的技能 / 代码调用,并返回完成后的响应。
{
  "model": "local",
  "messages": [
    { "role": "user", "content": "提取表格并总结结论。" }
  ],
  "skills": ["pdf"],
  "skills_discovery": false,
  "stream": true
}
skills_discovery 默认为 true。代码执行没有按请求开启的字段:运维方要么以 --code-exec 启动宿主,要么四个工具根本不会出现。智能体循环默认最多 8 个内部轮次;开启代码执行后默认 24 个;--skills-max-rounds 可明确设置 1–64 的上限。
子智能体:有界委派
在服务端聊天路径上——OpenAI /v1/chat/completions 与 /v1/responses、Ollama /api/chat/ollama,以及 Web UI 的 /api/chat——支持工具的模型可以把请求中相互独立的部分交给子智能体,再把它们的报告整合成一个答案。委派默认开启,是否使用由模型决定;不会强制生成子智能体。它既不依赖技能,也不依赖 --code-exec:五个协调工具会单独提供。
| 工具 | 行为 |
|---|---|
spawn_agent(task_name, task, agent_type?) | 启动一个子智能体并立即返回其 ID。agent_type 为 explorer(默认)、reviewer 或 worker。 |
wait_agent(agent_id?, timeout_ms?) | 等待某个直接子智能体;省略 ID 时等待全部直接子智能体。默认 10,000 ms,最长 60,000 ms。超时并不代表已完成。 |
send_input(agent_id, message) | 为运行中的子智能体排入一条后续消息,在其下一个生成边界送达;对已完成的子智能体则开始新的一轮。 |
close_agent(agent_id) | 取消一个子智能体及其所有后代。 |
list_agents() | 报告直接子智能体及其状态。 |
每个子智能体都运行在同一个已加载模型上,沿用父智能体的 token 上限、思考模式与采样设置。它从父智能体的 system/developer 指令和一份自包含的任务开始,拿不到父智能体的对话记录与附件,并返回一份有界报告。explorer 与 reviewer 始终只读:除五个协调工具外(因此子智能体可在 --agents-max-depth 范围内继续委派),只能使用 skills_list、skills_read,以及父智能体拥有时的 read_file。worker 默认同样只读;只有服务端以 --agents-allow-worker-tools 启动、且它的父级是根智能体或另一个可写的 worker 时,它才能使用父智能体已启用的可写工具,因此委派永远不会扩大权限。可写的 worker 与父智能体共享工作区与沙箱,只读子智能体读取的也是同一个工作区;不创建 Git worktree,也不做合并。调用方自己的工具绝不会传给子智能体;同一请求树中的宿主工具调用一次只执行一个。每个子智能体得到的是 KV 状态的独立副本,而不是共享页面。父智能体 prefill 之前,宿主会先为它与子智能体共享的前缀建立检查点,子智能体可以直接恢复这段前缀,而不必重新计算。
| 服务端选项 | 默认 | 范围与含义 |
|---|---|---|
--no-multi-agent | 委派开启 | 关闭委派。把 TS_NO_MULTI_AGENT 设为 0 以外的任意值效果相同。 |
--agents-max-concurrent | 3 | 1–32 个同时活跃的后代,不含根智能体 |
--agents-max-count | 8 | 每棵请求树 1–128 个子智能体 |
--agents-max-depth | 2 | 根以下 1–8 层 |
--agents-max-rounds | 8 | 每个子智能体每轮 1–64 个工具回合 |
--agents-max-generations | 48 | 每个请求 1–1024 次子智能体生成 |
--agents-timeout | 180 秒 | 每次子智能体运行 1–3600 秒 |
--agents-max-result-chars | 8000 | 每份报告 256–64000 个字符 |
--agents-allow-worker-tools | 关闭 | 允许 worker 使用父智能体已启用的可写工具 |
请求可以用 "multi_agent": false 退出委派;但它不能在宿主已关闭委派时重新开启,也不能提高任何上限或启用 worker 工具。wait_agent 运行期间,Web UI 的活动行带有一个可展开的面板,为每个子智能体显示一张实时卡片(任务、状态、当前工具、结果)。OpenAI 与 Ollama 响应只包含父智能体的文本。CLI 与 Ollama /api/generate 不做委派。TensorAgent 沿用宿主的默认上限,设置中有一个“Sub-agents”开关(默认开启),可从下一条消息起关闭委派。
只有能渲染工具声明并解析工具调用的家族才会得到这些工具——Mistral 3、Hunyuan Dense 与 DiffusionGemma 不会——结构化输出请求也永远不会。没有按模型大小设置的门槛。项目没有发布任何延迟、质量或委派率的测量数据。委派会额外消耗 token 与上下文,是否有益取决于具体工作负载。详见 docs/multi_agent.md。
模型家族限制
进程内循环要求模型家族既能携带工具声明,也能解析工具调用。不支持这种往返的家族会以内联方式获得选中的技能说明作为回退,但不会得到四个代码工具或子智能体工具;在受支持的家族中,这包括 Mistral 3、Hunyuan Dense 与 DiffusionGemma。Qwen 3.8 Flash Next 现已能完成这种往返。TensorSharp 会记录这一限制,而不是假装代码执行可用。