终端
在本地运行模型
通过 CLI 聊天、处理多模态输入、批量任务与基准测试。首次运行指南涵盖 SDK 安装、模型下载与后端配置。
CLI 快速开始 →本地 AI,原生 .NET。
用同一个 C# 推理引擎运行文本与多模态模型、生成图像和视频,并构建智能体工作流。通过 CLI、浏览器聊天、兼容 Ollama 与 OpenAI 的 API,或你自己的 .NET 应用使用它。
你自己的模型与硬件,本地推理无需按量计费的 API。
从第一次本地聊天,到提供模型服务、调用工具的应用。
使用 Gemma、Qwen、DeepSeek、GLM 等模型聊天、推理,处理图像、音频和文档。可用的输入类型取决于模型。
浏览文本模型 →用 Qwen-Image 2.1 与 8 步 Turbo 生成和编辑图像,支持蒙版编辑与兼容的 LoRA 插件。用 LTX 2.5 或 MiniMax-H3 联合生成视频与立体声音频,或用 Wan 生成视频。
浏览媒体模型 →把文件、文件夹与已保存聊天导入本地集合,检索文档、OCR 与媒体派生文本,并在回答中追溯引用来源。
建立可复用资料库 →通过兼容 OpenAI/Ollama 的 API 运行 Arctic Embed、MiniLM,以及支持文本/图像/音频/视频的 EmbeddingGemma 2。
使用嵌入模型 →通过 AgentHost 添加 Agent Skills、文件与代码工具,以及有界子智能体委派。按任务配置允许使用的工具权限。
构建智能体工作流 →选择纯 C# CPU,或原生 CPU、CUDA、Vulkan、Metal、MLX 后端。各路径的模型、量化与硬件支持范围均有文档说明。
选择计算后端 →在 C# 中嵌入推理、运行 CLI,或托管浏览器聊天及兼容 Ollama、OpenAI 的 API。TensorAgent 将同一引擎带到本地应用中。
通过 C# 集成 →从适合当前任务的界面开始,三种方式都使用 TensorSharp。
终端
通过 CLI 聊天、处理多模态输入、批量任务与基准测试。首次运行指南涵盖 SDK 安装、模型下载与后端配置。
CLI 快速开始 →浏览器与 API
启动服务器与 Web UI,再通过聊天、Responses 和嵌入端点连接客户端。
服务器与 Web UI 指南 →桌面应用
在 Apple Silicon Mac 或 Windows x64 上安装,在应用内下载模型,开始聊天或使用工具完成任务。
下载与安装 →第一次从源码运行?可从 Gemma 4 E4B 教程开始。Apple Silicon、NVIDIA、Vulkan 与 CPU 的配置见计算后端指南。模型权重需要单独下载。
发行包对应各自的发布标签,当前源码可能包含较新功能。可用下载文件与平台要求见桌面版指南。iPhone 与 iPad 通过源码构建。
同一个引擎,四种用法,每张都是真实运行的原样截图。点击可查看原图。
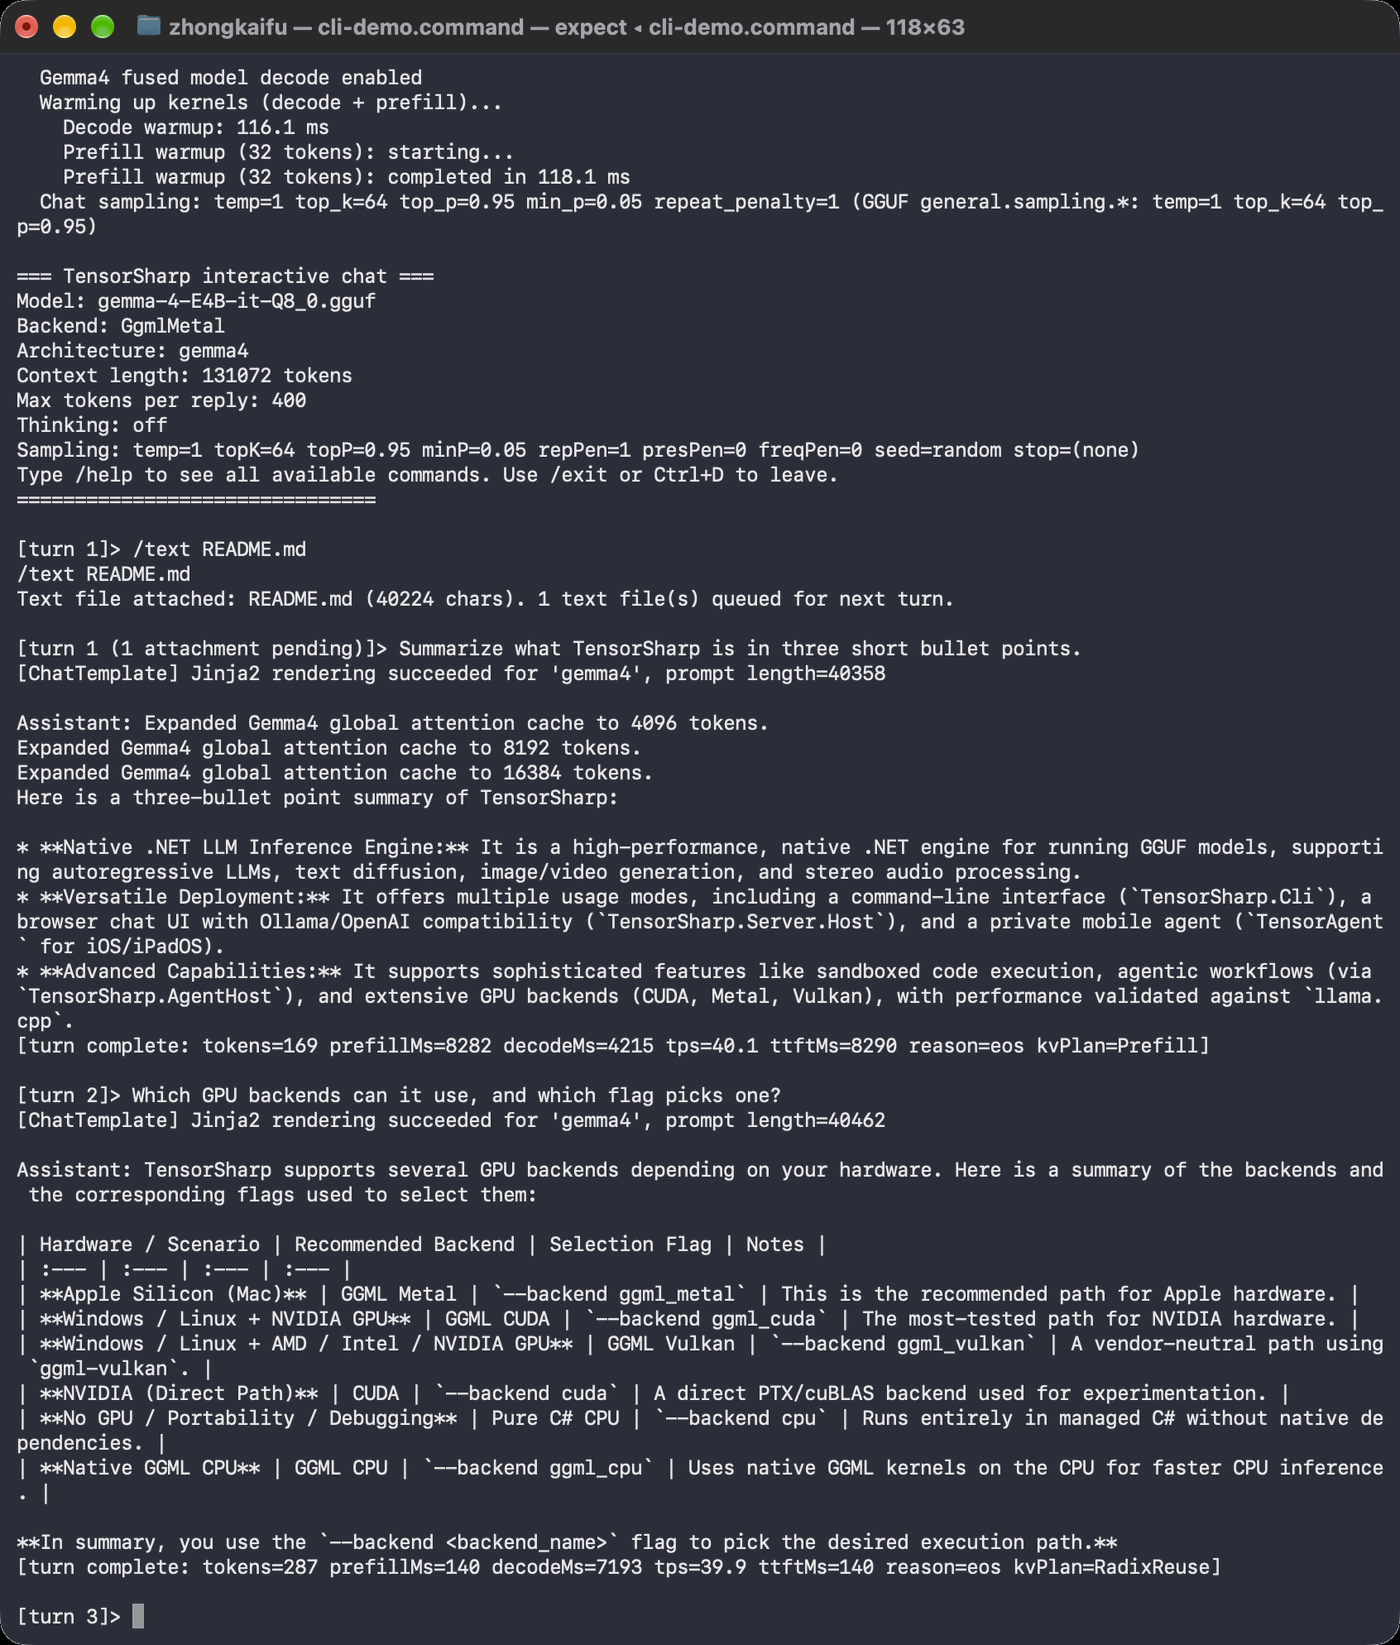
在终端里运行模型、聊天与基准测试。
命令行 →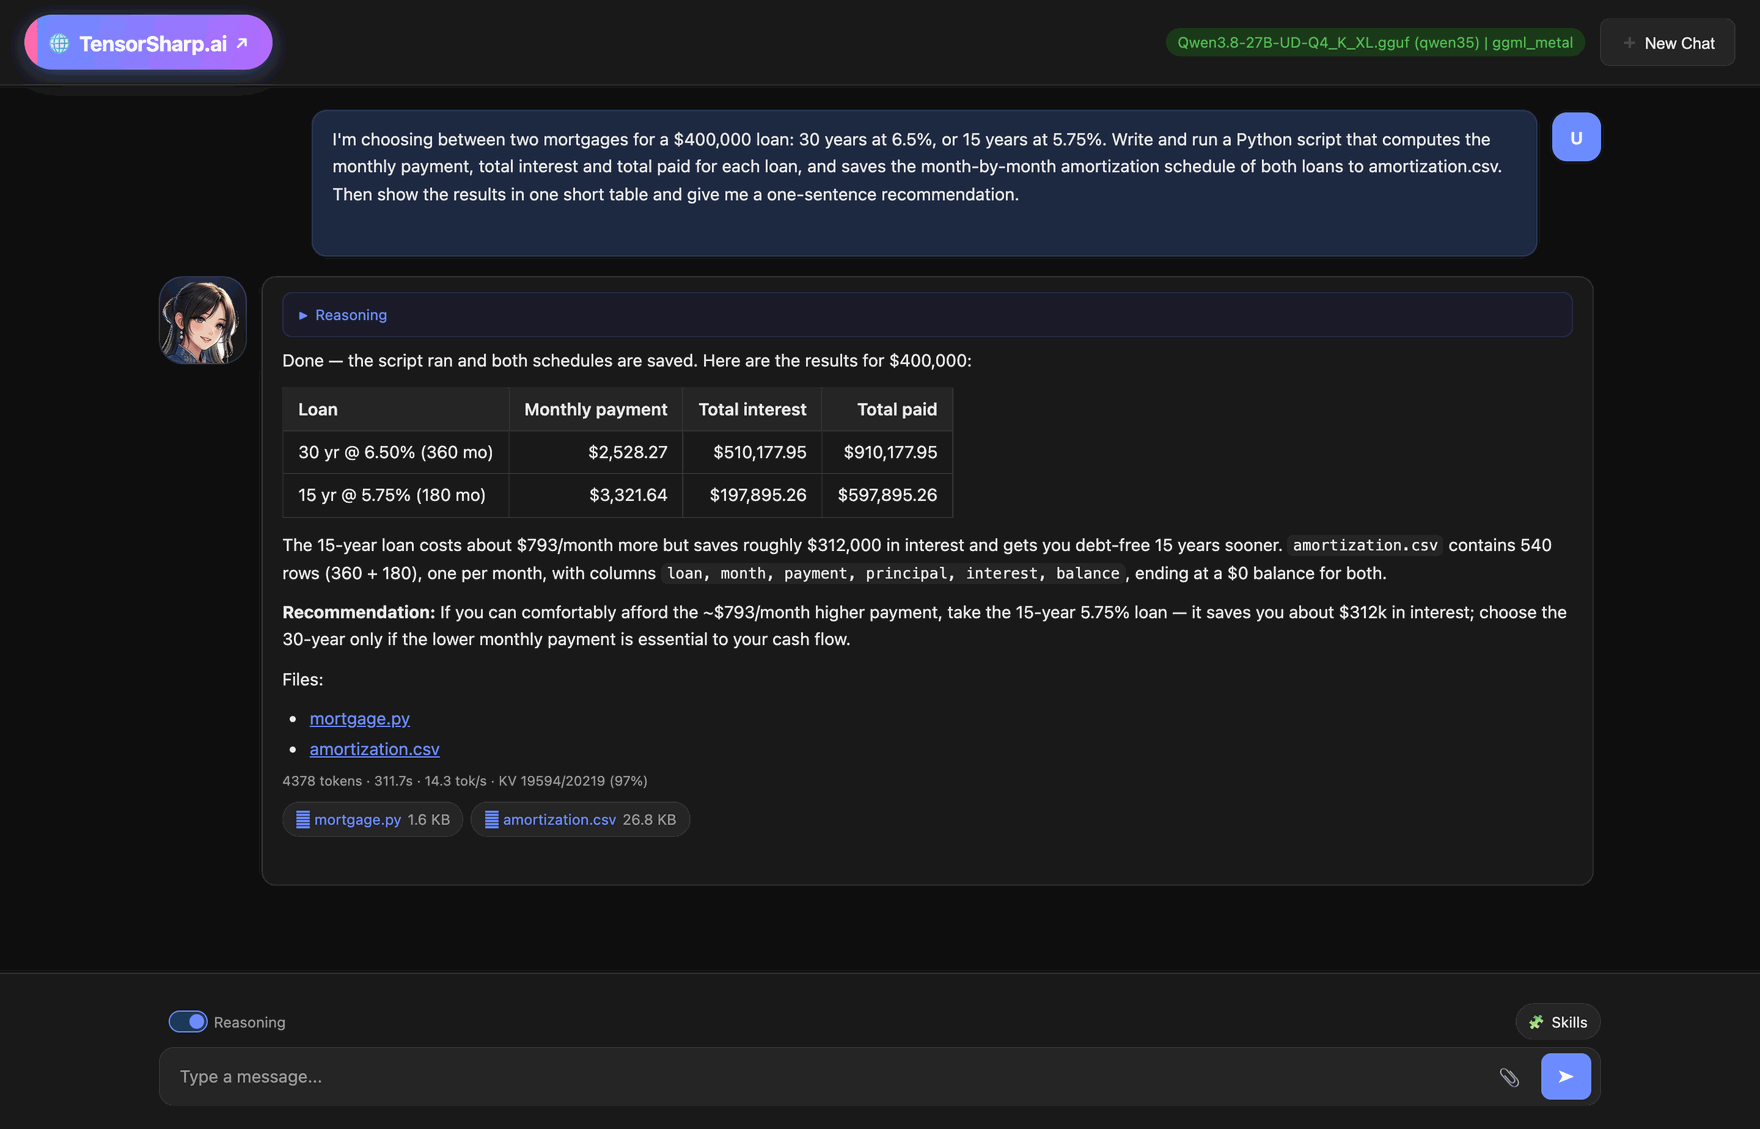
浏览器聊天,外加兼容 Ollama 与 OpenAI 的 API。
服务器与 Web UI →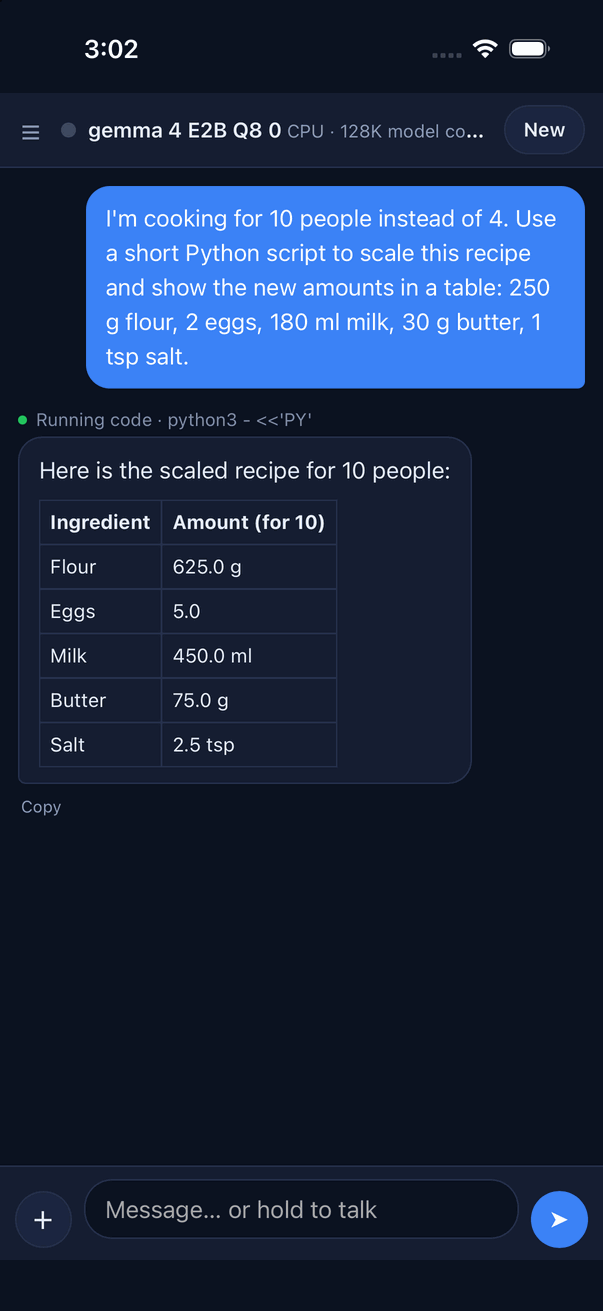
本地聊天与代码工具,此处展示 iPhone 模拟器。
iOS 版 TensorAgent →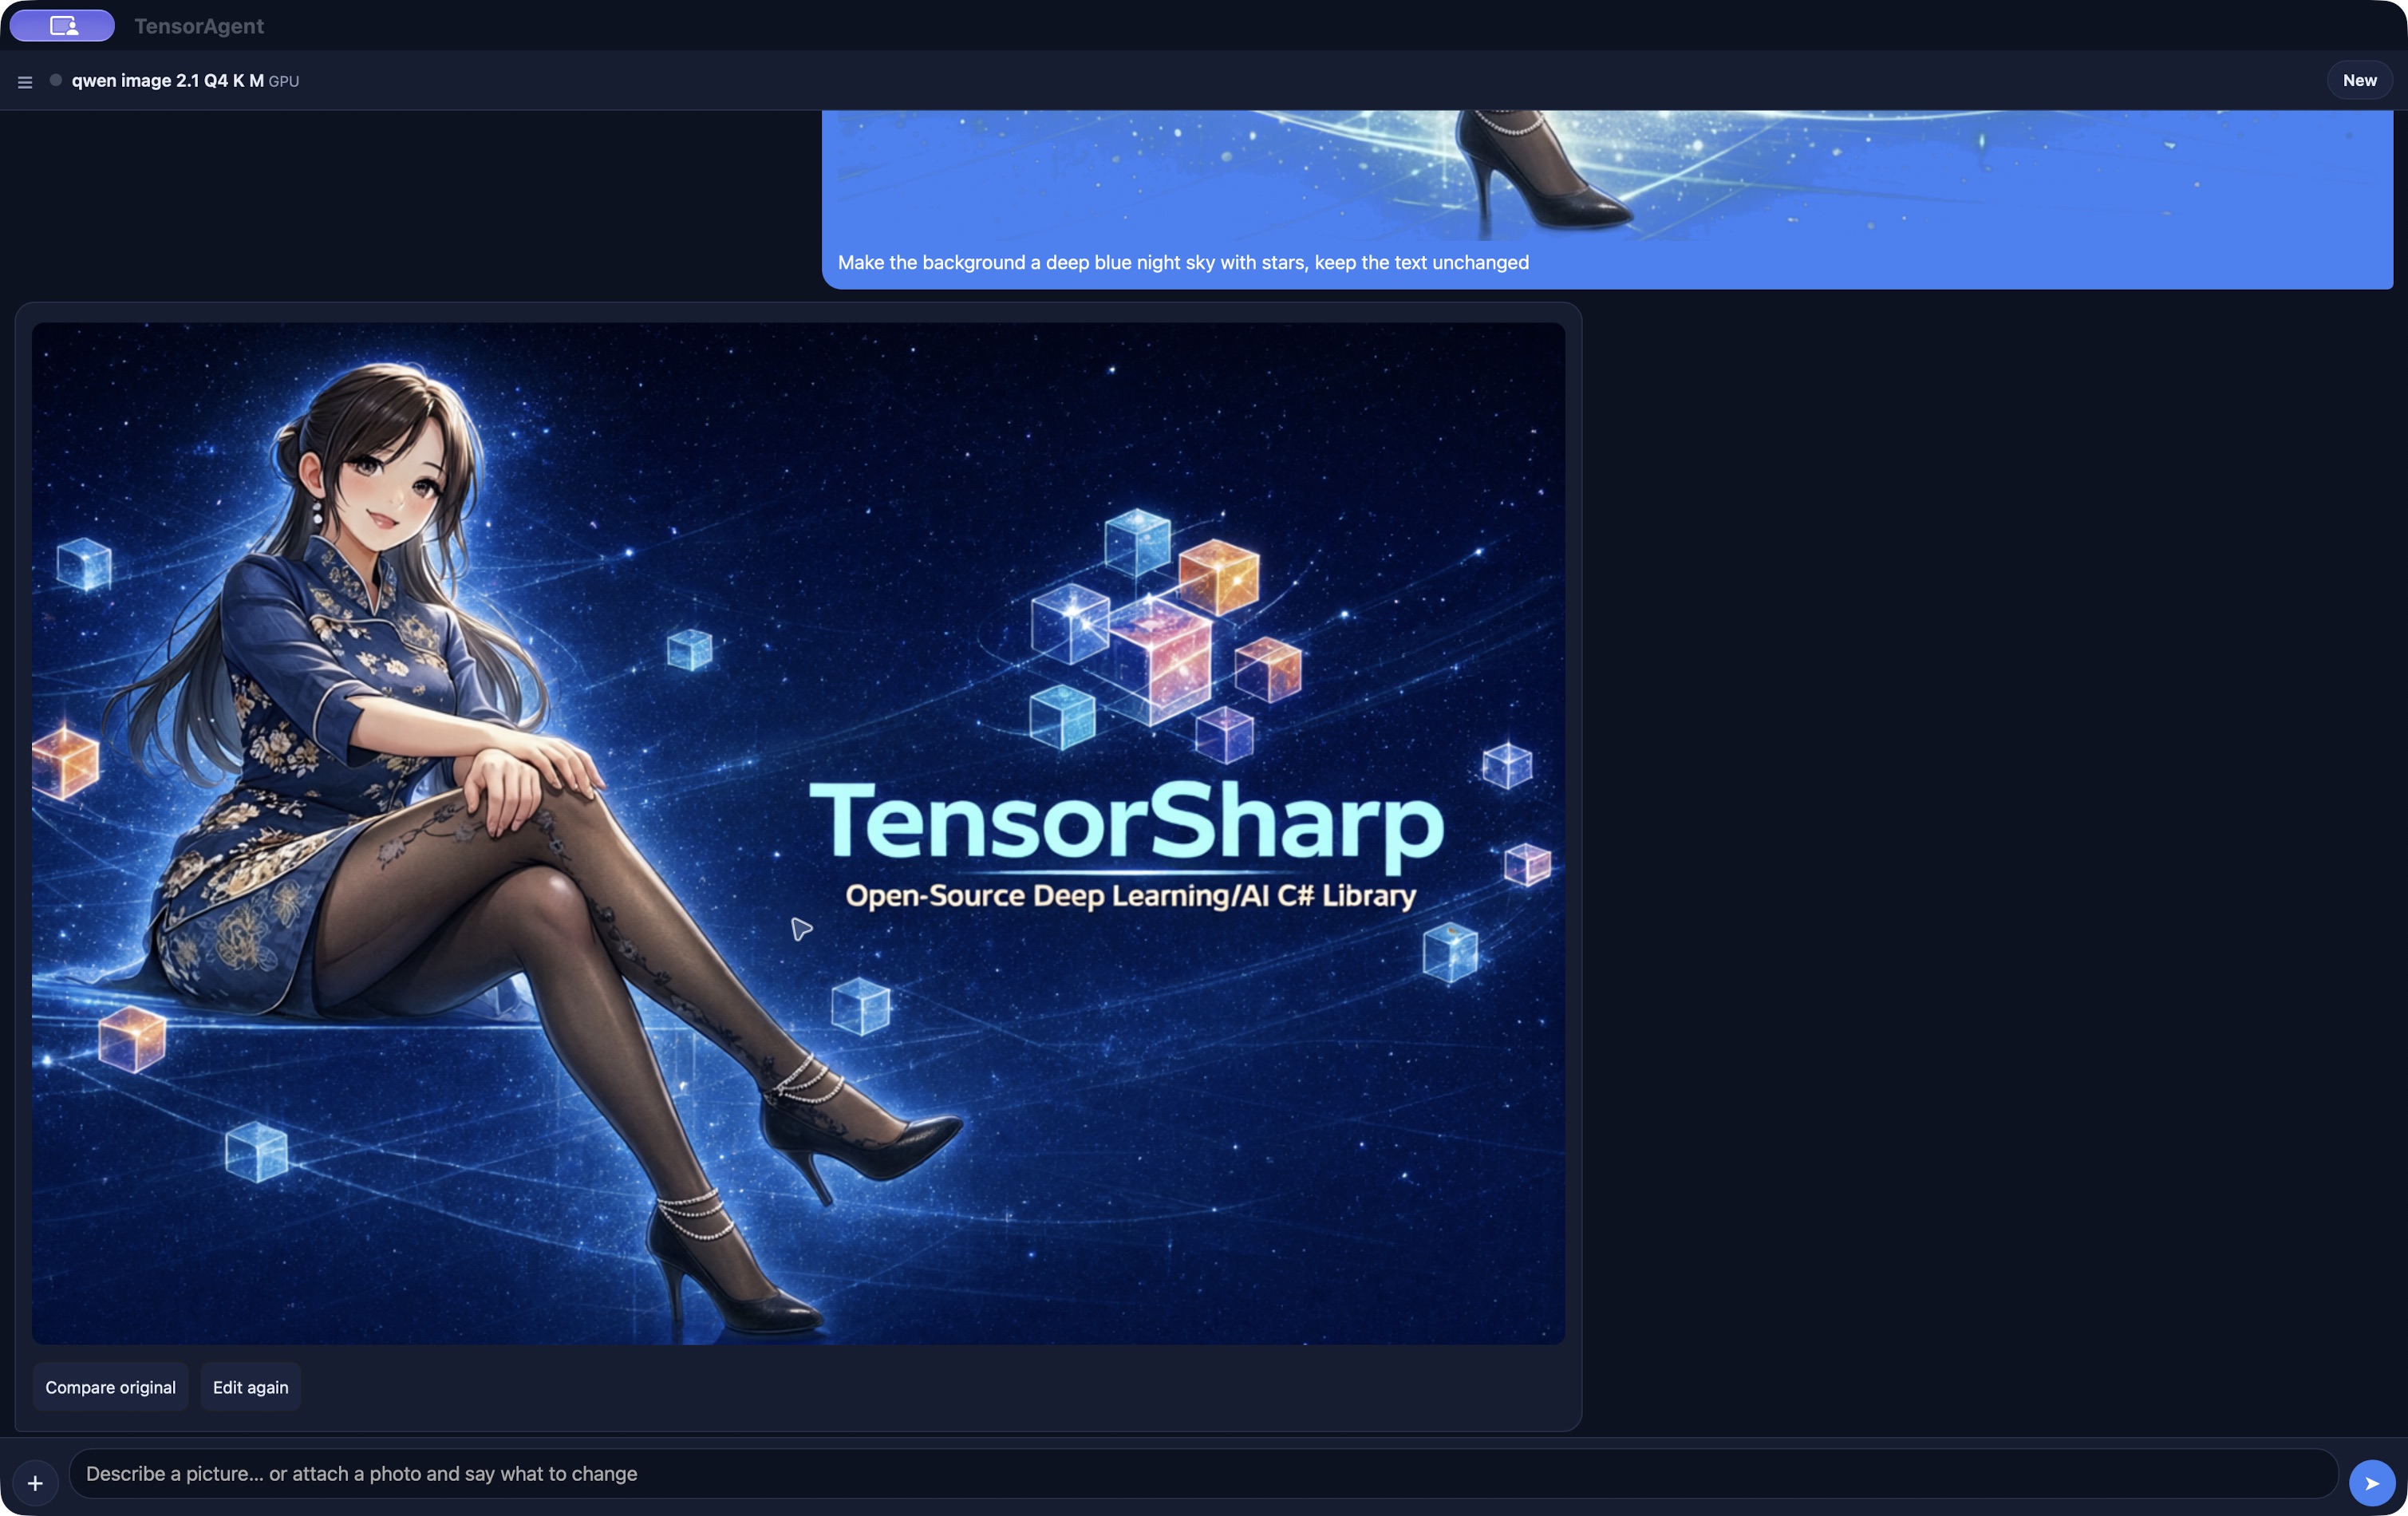
Qwen-Image 2.1 按指令编辑附加的图像;同一应用还支持文本聊天、文件、代码、浏览器技能与视频。
Mac 与 Windows 上的 TensorAgent →各家族的后端、多模态输入、工具调用与验证范围不同。查看完整能力矩阵 →
默认启用连续批处理、分页 KV 缓存和 Radix 前缀共享。支持的模型还可选择推测解码,以进一步降低延迟。
了解服务端优化 →部分架构支持多 GPU 层分布、张量并行和多节点执行。基于 SSD 的专家卸载可让部分大型 MoE 模型在权重超过内存容量时运行。
查看扩展支持范围 →面向开发者、研究者,以及希望理解本地推理原理的读者:从架构、API、模型卡与实测结果继续探索。
Zhongkai Fu 所著的两本书,将 TensorSharp 源码串联为循序渐进的实现路线。
Qwen · 推理与智能体
Qwen Dense and MoE Models with TensorSharp and TensorAgent
以 TensorSharp 和 TensorAgent 为工程参考,使用 C# 探索从张量、分词到 Qwen 稠密与 MoE 推理的实现,再延伸至工具、技能、代码执行与沙箱边界,串联 GPU 优化、多模态输入及桌面和移动端部署。
Gemma 4 · 多模态推理
Building a Multimodal LLM Inference Engine from Scratch with TensorSharp and Gemma 4 E4B
以 Gemma 4 E4B 为具体示例,使用 C# 与 .NET 构建多模态推理引擎,从张量存储、GGUF、量化和分词走向图像、视频与音频输入,并通过数值验证、缓存和批处理理解正确性与性能。
TensorSharp 与 TensorAgent 免费提供。如果它们对你有帮助,一杯咖啡可以支持后续开发。
