命令行 (CLI)
TensorSharp.Cli 是用于本地提示词、多模态实验、提示词检查、JSONL 批处理工作流、交互式 REPL 与内置基准测试的控制台宿主。构建后二进制位于 TensorSharp.Cli/bin/...。
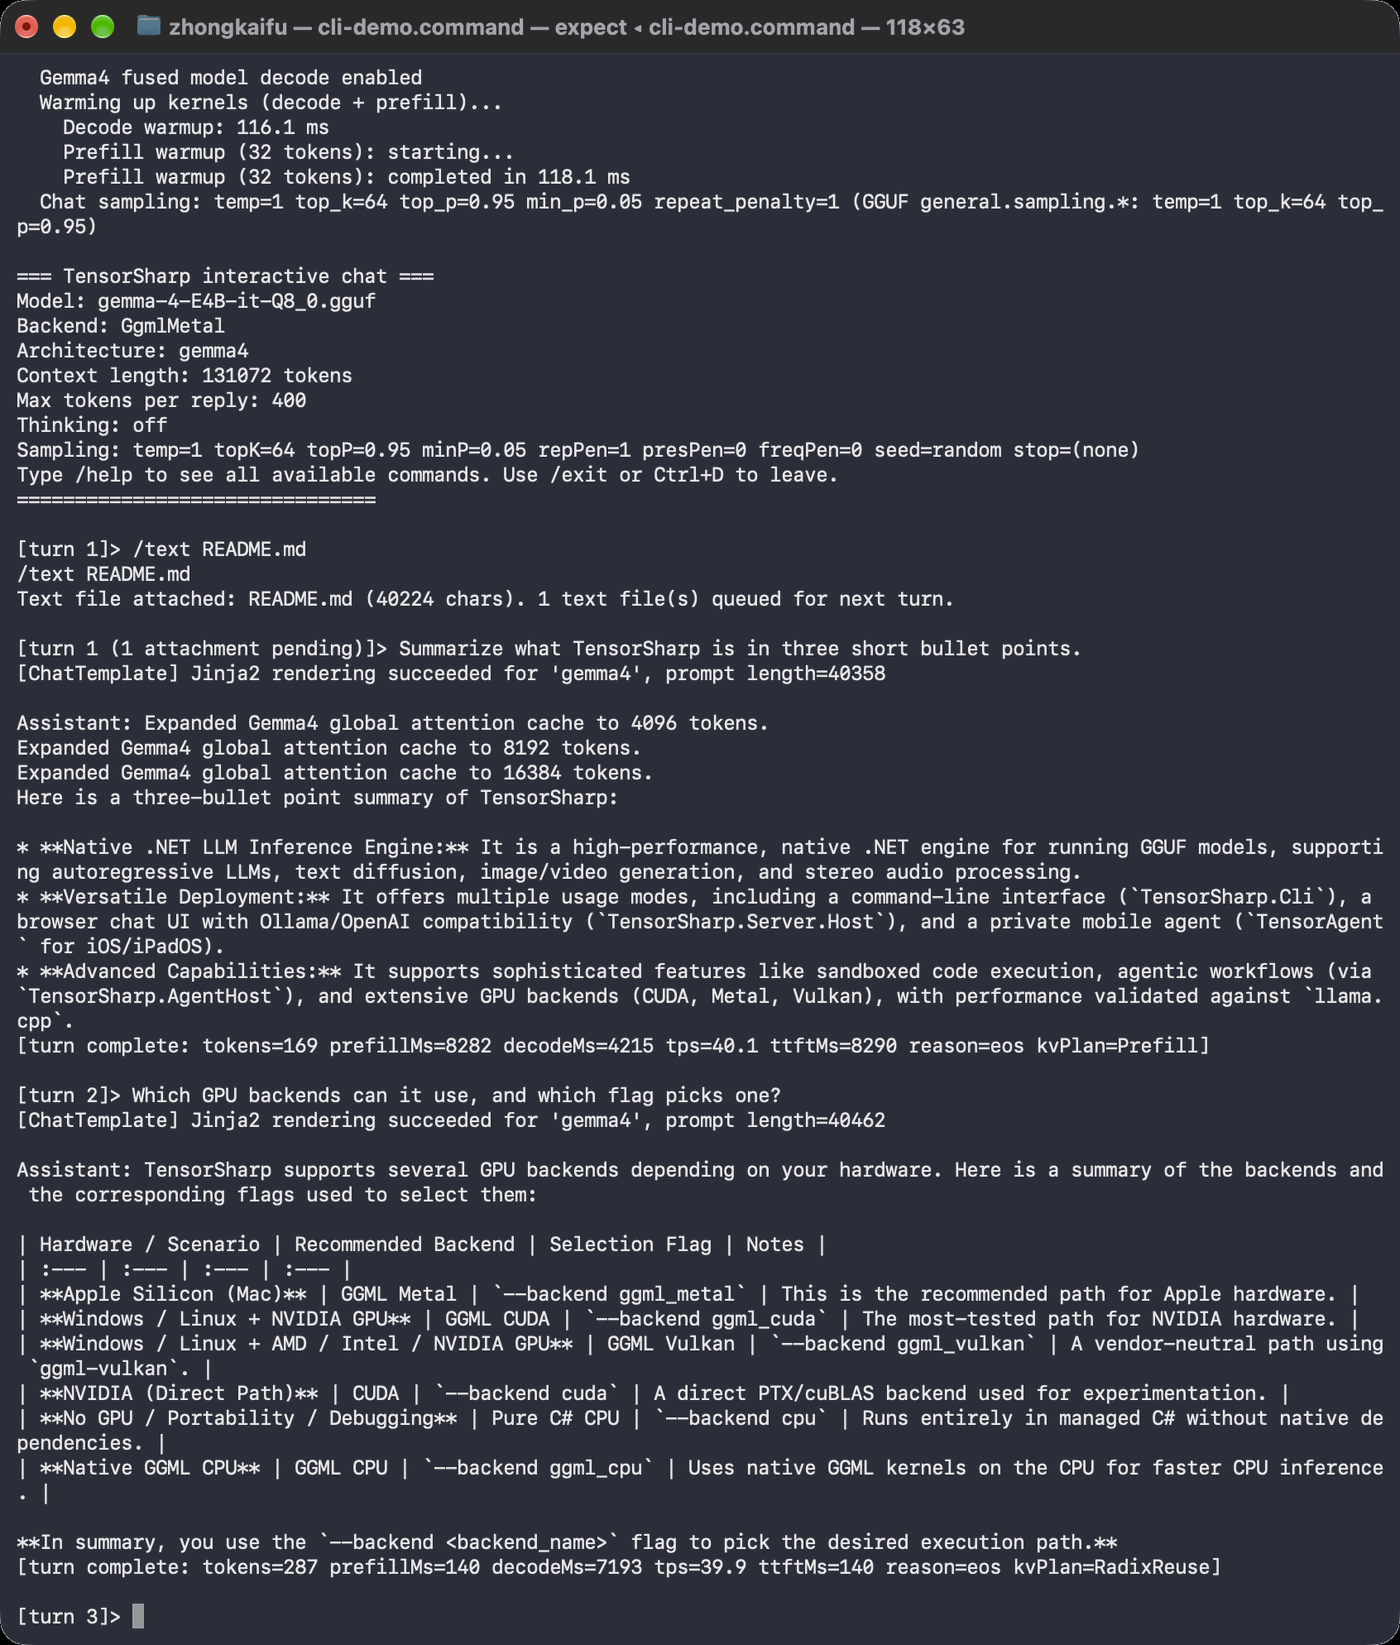
ggml_metal 的交互式聊天(--chat),机器为 Apple M5 Pro。/text 附加了项目 README(40,224 个字符)。两次回答的解码速度都约为每秒 40 个 token;第二轮复用已缓存的 README,首个 token 在 140 毫秒内返回。参见交互式 REPL 命令。快速开始
请在 TensorSharp 仓库根目录执行,并先按平台安装 .NET 10 SDK。快速开始会构建原生 GGML 后端,并运行示例使用的 gemma-4-E4B-it-Q8_0.gguf(7.48 GiB)。请为模型下载与首次 restore/构建预留时间,耗时取决于网络与机器性能。原生源码构建还需要 Git、网络访问、CMake 与可用的 C++ 工具链。
Linux + NVIDIA
TENSORSHARP_GGML_NATIVE_ENABLE_CUDA=ON dotnet build TensorSharp.slnx -c Release -p:TensorSharpSkipMlxNative=true
curl --create-dirs --fail -L "https://huggingface.co/ggml-org/gemma-4-E4B-it-GGUF/resolve/main/gemma-4-E4B-it-Q8_0.gguf?download=true" -o models/gemma-4-E4B-it-Q8_0.gguf
echo "请用一段话说明本地推理。" > prompt.txt
dotnet run --project TensorSharp.Cli -c Release --no-build -- --model models/gemma-4-E4B-it-Q8_0.gguf --input prompt.txt --max-tokens 128 --backend ggml_cuda
Windows PowerShell + NVIDIA
$env:TENSORSHARP_GGML_NATIVE_ENABLE_CUDA = 'ON'
dotnet build TensorSharp.slnx -c Release -p:TensorSharpSkipMlxNative=true
curl.exe --create-dirs --fail -L "https://huggingface.co/ggml-org/gemma-4-E4B-it-GGUF/resolve/main/gemma-4-E4B-it-Q8_0.gguf?download=true" -o models\gemma-4-E4B-it-Q8_0.gguf
Set-Content -Encoding utf8 prompt.txt "请用一段话说明本地推理。"
dotnet run --project TensorSharp.Cli -c Release --no-build -- --model models\gemma-4-E4B-it-Q8_0.gguf --input prompt.txt --max-tokens 128 --backend ggml_cuda
省略 --input 时,CLI 会退回内置的 What is 1+1? 提示词;若要进行自定义的单次文本推理,请把提示词保存到文件并通过 --input 传入。--prompt 仅用于图像与视频生成模型的提示词。
在其他原生后端上运行 Gemma 4 E4B
Apple Silicon 请省略 CUDA 环境变量并使用 ggml_metal;受支持的 Windows/Linux Vulkan GPU 请改为请求 TENSORSHARP_GGML_NATIVE_ENABLE_VULKAN=ON 并使用 ggml_vulkan;ggml_cpu 运行原生 CPU 内核,无需 GPU。同一仓库还提供内存占用更低的 gemma-4-E4B-it-Q4_K_M.gguf。纯文本不需要 mmproj;只有图像、视频或音频输入才需要通过 --mmproj 添加匹配的 mmproj-gemma-4-E4B-it-Q8_0.gguf。完整平台语法见快速开始。
示例
请在仓库根目录运行这些源码命令。替换示例路径,并选择构建所支持的原生后端。
# 文本推理(macOS)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --output result.txt \
    --max-tokens 200 --backend ggml_metal

# Windows/Linux + NVIDIA GPU 上的文本推理
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --output result.txt \
    --max-tokens 200 --backend ggml_cuda

# 在任意 Vulkan GPU(AMD / Intel / NVIDIA)上的文本推理
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --output result.txt \
    --max-tokens 200 --backend ggml_vulkan

# 多 GPU 主机:先列出可见的 Vulkan 设备,再按索引选择
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- --list-gpus
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --max-tokens 200 \
    --backend ggml_vulkan --gpu-device 1

# 交互式逐轮聊天(REPL),带 KV 缓存复用与斜杠命令
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_metal --interactive
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_metal -i \
    --system "You are a terse assistant." --temperature 0.7 --top-p 0.9 --think

# DSpark 块级投机解码(DeepSeek V4):--model 指向分片 GGUF 的第一片,
# --draft-model 指向独立的 DSpark 草稿器(仅限 cuda / ggml_cuda)。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <DeepSeek-V4-Flash-...-00001-of-00005.gguf> --backend ggml_cuda --layer-split 4 \
    --draft-model <DSpark-drafter.gguf> --input prompt.txt --max-tokens 200 --temperature 0

# GLM 5.x:--model 指向第一个分片,同一组的其余分片由 GgufFile 自行找到。
# --layer-split 3 将整层放到 3 张本地 GPU(例如 3×96 GB);
# 自报的 1M 上下文则按权重放置后剩余的显存缩定。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <GLM-5.2-UD-IQ2_XXS-00001-of-00006.gguf> --backend ggml_cuda --layer-split 3 \
    --input prompt.txt --max-tokens 200 --think

# GLM-5.3(非 Flash)与 GLM-5.2 是同一套 79 块 glm-dsa 结构 —— 256 个路由专家取
# top-8 外加一个共享专家、带 lightning indexer 的 MLA —— 因此它走 GLM-5.2 的加载
# 路径,不需要新代码也不需要新参数,只有文件不同。unsloth/GLM-5.3-GGUF 每个量化
# 各占一个子目录,每个都是多分片的一组(UD-Q2_K_XL 为七个分片、236.4 GiB);它仅
# 文本:该仓库任何量化都没有发布 mmproj,在 glm-dsa 上传 --mmproj 只会告警并忽略。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <UD-Q2_K_XL/GLM-5.3-UD-Q2_K_XL-00001-of-00007.gguf> --backend ggml_cuda --layer-split 8 \
    --input prompt.txt --max-tokens 200 --think
多模态
# 图像推理(Gemma 4、Qwen 3.5-family);--mmproj 指定投影器(见下文)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --mmproj <mmproj.gguf> --image photo.png \
    --max-tokens 200 --backend ggml_metal

# 视频推理(Gemma 4)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --mmproj <mmproj.gguf> --video clip.mp4 \
    --max-tokens 200 --backend ggml_metal

# 音频推理(Gemma 4)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --mmproj <mmproj.gguf> --audio speech.wav \
    --max-tokens 200 --backend ggml_metal

# PDF 文档问答(--input 是问题;扫描件/纯图像 PDF 需要视觉模型 +
# --mmproj,含文本的 PDF 可使用任意模型)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --pdf report.pdf --input question.txt \
    --max-tokens 400 --backend ggml_metal
推理、工具与采样
# 思考 / 推理模式
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --max-tokens 400 --backend ggml_metal --think

# 工具调用
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --max-tokens 300 --backend ggml_metal \
    --tools tools.json

# 带采样参数(单次运行默认为贪心解码)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --max-tokens 200 --backend ggml_metal \
    --temperature 0.7 --top-p 0.9 --top-k 40 --repeat-penalty 1.2 --seed 42
图像生成与编辑(Qwen-Image-2.1)
# Qwen-Image-2.1:不带 --image 时生成图像,带 --image 时编辑图像(重复该参数
# 可传入多张参考图)。该配置会下载 DiT、专用 2.1 VAE 以及 Qwen3-VL-8B 文本编码器
# 与 mmproj。默认:2048x2048、40 步 Euler、CFG 1。
dotnet run --project TensorSharp.Cli -c Release --no-build -- \
  --config config/qwen-image-2.1.json \
  --prompt 'A small orange cat beside a blue ceramic vase, soft daylight, detailed photograph' \
  --width 2048 --height 2048 --diffusion-steps 40 --cfg 1 \
  --diffusion-seed 42 --output generated.png
dotnet run --project TensorSharp.Cli -c Release --no-build -- \
  --config config/qwen-image-2.1.json \
  --image generated.png \
  --prompt 'Change the blue vase to a red vase. Preserve the cat, lighting and composition.' \
  --width 2048 --height 2048 --diffusion-steps 40 --cfg 1 \
  --diffusion-seed 42 --output edited.png

# LoRA 插件:config/lora/ 中的插件在首次使用时下载权重,步数蒸馏插件还会带上
# 自己的采样配方(这里是 6 步、CFG 1)。
dotnet run --project TensorSharp.Cli -c Release --no-build -- \
  --config config/qwen-image-2.1.json \
  --lora config/lora/qwen-image-2.1-viggle-turbo.json \
  --prompt 'A small orange cat beside a blue ceramic vase, soft daylight, detailed photograph' \
--width 1024 --height 1024 --diffusion-seed 42 --output turbo.png局部编辑:在 --image photo.png 上增加 --mask selection.png。同尺寸的灰度蒙版用白色表示编辑、黑色表示保护;--mask-mode alpha、--mask-invert、--mask-feather、--mask-crop 与 --mask-crop-padding 控制选区。结果保持源图尺寸。完整示例与蒙版语义 →
config/lora/ 中的 Qwen-Image-2.1 步数蒸馏插件 —— qwen-image-2.1-viggle-turbo.json、-pruna-8step.json、-pruna-5step.json 与 -fun-acc-4step.json —— 会用它们训练时的 4–8 步配方取代默认的 40 步,因此是图像生成最主要的提速杠杆。显式的 --diffusion-steps / --cfg 仍然优先,但配方没有对应调度的步数会被拒绝。伴随文件、尺寸、草图设置与 LoRA 插件见图像生成。
LTX 2.5: 使用 --config config/ltx-2.5-distilled.json;NVIDIA 用 cuda/ggml_cuda,Apple 用 mlx/ggml_metal(实际为 MLX),CPU 别名选择直接 CPU。默认 1024×1024×17、24 fps,宽高为 64 倍数、帧数 8k+1;8 步半尺寸加 3 步精修,CFG 1。 五文件、音频、条件与限制 →
视频生成
MiniMax-H3 在同一个打包潜变量里同时去噪视频与原生 32 kHz 立体声音轨,所以声音和画面来自同一次前向。它经过 CFG 蒸馏,因此必须传 --cfg 1.0(更高的取值会被直接拒绝),默认 20 步。像前两个示例那样减少基础步数可以更快得到预览,但会损失一些质量;专为少步数蒸馏的调度是下文的 Turbo 插件:
# 文本 -> H.264 MP4 外加一个旁挂 WAV。写出 fox.mp4 与 fox.wav。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <minimax_h3_fl2va_pruned-Q4_K.gguf> --backend ggml_metal \
    --prompt "a red fox trotting through falling snow, cinematic" \
    --width 640 --height 384 --video-frames 22 --diffusion-steps 8 --cfg 1.0 \
    --output fox.mp4

# 让一张照片动起来:在 FL2VA 权重上,这张图像就是首帧。
# 再加 --end-image 可以把尾帧也钉住(--video-mode fl2v)。不给 --width/--height
# 时,画布按 MiniMax 的 768p 配方取自这张照片(3:2 照片为 1152x768),人脸得以保留;
# 两者都给出则改为固定所给的尺寸,例如用更小的尺寸做更快的预览。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <minimax_h3_fl2va_pruned-Q4_K.gguf> --backend ggml_metal \
    --image portrait.jpg --video-mode i2v \
    --prompt "the person turns toward the camera and smiles" \
    --video-frames 22 --diffusion-steps 8 --cfg 1.0 \
    --output animated.mp4

# 参考:保留主体,围绕它构建一个新场景。需要 Ref2VA 权重,
# 最多九个 --ref-image;--ref-video / --ref-audio 则接受片段与音轨。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <minimax_h3_ref2va_pruned-Q4_K.gguf> --backend ggml_metal \
    --ref-image person.jpg --ref-image bottle.png --video-mode ref \
    --prompt "she holds the bottle up to the light on a rooftop at golden hour" \
    --width 640 --height 384 --video-frames 22 --diffusion-steps 20 --cfg 1.0 \
--output rooftop.mp4i2v / fl2v 需要 fl2va 权重,ref 需要 ref2va —— 它们是两个不同的文件而不是开关,用错时报错信息会直接点名另一个文件。宽高向上取整到 32 的倍数,帧数向上对齐到 17k+5 网格(5、22、39、56、73、90……),帧率固定为 24。音轨保留为独立 .wav;FFmpeg 与 Apple AVFoundation 导出路径也可将其混入 MP4,其他提供器可能返回分离音轨:ffmpeg -i fox.mp4 -i fox.wav -c:v copy -c:a aac fox_with_audio.mp4 可以把两者合并。--no-audio 则完全跳过音频 VAE。→ H3 需要的四个文件
MiniMax-H3 Turbo:LightX2V 为 FL2VA 检查点做的步数蒸馏 LoRA 以两份插件配置提供:config/lora/minimax-h3-fl2v-turbo-8step.json 与 -4step.json。每份在首次使用时下载 1.38 GB 权重,并按自己的调度只跑 8(或 4)步——Euler、视频 shift 6、音频 shift 3、CFG 1;4 步配方为推断所得,因为发布方没有给出该版本的配方。请不要设置 --diffusion-steps、--flow-shift 与 --sampler:与配方冲突的取值会在下载任何文件之前以一行 Configuration error: 终止运行。Ref2VA 检查点不接受它。→ 插件、锁定的配方与已验证的范围
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --config config/minimax-h3-fl2va.json \
    --lora config/lora/minimax-h3-fl2v-turbo-8step.json \
    --prompt "a red fox trotting through falling snow, cinematic" --output fox-turbo.mp4
Wan 2.1 / 2.2 只生成视频,而在那里,--model 指向哪个权重决定了整体耗时:
# 提示词 -> H.264 MP4。UMT5-XXL 文本编码器与视频 VAE 会在 DiT GGUF
# 旁边自动解析(也可用 --video-text-encoder / --video-vae 指定)。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <Wan2.2-TI2V-5B-Q8_0.gguf> \
    --prompt "A red fox trotting through falling snow, cinematic" \
    --video-frames 81 --fps 24 --output out.mp4 --backend ggml_cuda

# 图像 -> 视频:图像作为首帧,提示词驱动运动
# (仅 Wan 2.2 TI2V-5B 与 A14B I2V 支持)。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <Wan2.2-TI2V-5B-Q8_0.gguf> --image first_frame.png \
    --prompt "the camera pushes in as the waves rise" \
    --video-frames 81 --fps 24 --flow-shift 5.0 --output out.mp4 --backend ggml_cuda

# 快车道:把 --model 指向一个步数蒸馏权重。命令的其他部分完全不变;
# 仅凭文件名,这次运行就会切换为 4 次无引导前向。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <Wan2_2-TI2V-5B-Turbo-Q8_0.gguf> --image first_frame.png \
    --prompt "the camera pushes in as the waves rise" \
--video-frames 121 --fps 24 --output out.mp4 --backend ggml_metal步数蒸馏是最大的一个提速杠杆,而且它不是一个开关。基础的 Wan2.2-TI2V-5B 走官方配方 50 步 × 2 次 CFG = 100 次 DiT 前向;蒸馏后的 Turbo / Lightning / FastWan 权重在训练时就不使用引导,只需 4 次。TensorSharp 会从 DiT 文件名识别它(turbo、distill、lightning、lightx2v、fastwan、-dmd,或显式的 …-4steps-… / …8step…,取值 1–16),并在加载时打印 step-distilled checkpoint detected -> 4 steps, guidance off。在 M5 Pro 上、1088×832 × 121 帧的同一个请求,基础权重约需 3 h 30 m,Turbo 只需 17 m 30 s。--diffusion-steps / --cfg 可覆盖识别到的取值。→ 去哪里下载 · 实测数据
DiffusionGemma 与检查
# DiffusionGemma 文本扩散生成
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <diffusion-gemma.gguf> --input prompt.txt --backend ggml_metal \
    --max-tokens 256 --diffusion-steps 48 --diffusion-seed 0

# 带图像的 DiffusionGemma(仅图像输入,不支持音频与视频)。Gemma 4 视觉塔来自
# mmproj GGUF;diffusiongemma-26B-A4B-it 没有发布 mmproj,则可直接取自其
# HuggingFace 分片 model-00011-of-00011.safetensors。
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <diffusion-gemma.gguf> --mmproj <model-00011-of-00011.safetensors> \
    --image photo.png --input prompt.txt --backend ggml_metal --max-tokens 256

# 检查渲染后的提示词与分词,但不运行推理
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input prompt.txt --dump-prompt
批处理与基准测试
# 批处理(JSONL)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --input-jsonl requests.jsonl \
    --output results.txt --backend ggml_metal

# 带 KV 缓存复用的多轮对话模拟(与 Web UI 行为一致)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --multi-turn-jsonl chat.jsonl \
    --backend ggml_metal --max-tokens 200

# 吞吐基准:best-of-N 的 prefill 与 decode 计时
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_metal \
    --benchmark --bench-prefill 256 --bench-decode 128 --bench-runs 3
JSONL 格式为每行一个 JSON 对象,可带可选的采样字段(temperature、top_k、top_p、min_p、repetition_penalty、repeat_last_n、presence_penalty、frequency_penalty、seed、stop);某一行没写的字段沿用命令行上的值,--repeat-last-n 窗口也不例外:
{"id": "q1", "messages": [{"role": "user", "content": "What is 2+3?"}], "max_tokens": 50}
{"id": "q2", "messages": [{"role": "user", "content": "Write a haiku."}], "max_tokens": 100, "temperature": 0.8}配置文件(--config)
可以用 --config 传入一个 JSON 文件,取代冗长的命令行;服务端读取相同格式。命令行参数始终优先——命令行自己设置了某个单值参数时,文件中该参数的条目会在解析之前被丢弃(不展开、不替换其中的变量、也永远不会发起其下载),因此可以在多台机器上复用同一个文件,只覆盖需要变化的部分。每个被覆盖的参数会在 stderr 上打印一行 [config] --X is set on the command line, so the value from '<file>' is ignored …。--config 可重复以叠加多个文件(后出现的文件中的条目以同样方式取代先前的条目)。可重复的参数——--stop、--skills-dir、--skill、--lora、--lora-scale、--lora-config、--image 与各个 --ref-* 输入——则保留文件中的值并把命令行的值追加在后面。允许注释与尾随逗号。
# 使用该文件,但本次运行覆盖后端
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --config config/cli-basic.json --backend ggml_cpu
键名与下方长选项名相同(可带或不带前缀 --)。字符串/数字展开为 --key value,true 展开为裸开关 --key,数组展开为重复的标志。false 与 null 不产生任何参数,因此要关闭默认开启的选项,请写它的否定形式("no-continuous-batching": true)。lora-scale 与 lora-config 不能写成数组,已移除的选项(如 offload-cpu)作为键也会被拒绝。CLI 会忽略它不认识的键,因此 port 这类仅服务端使用的键在这里不起作用;repeat-last-n 在两个宿主上拼写相同,对两者都生效。
变量。 在 "variables"(别名 "vars")中定义一次共享值,用 ${name} 在任意字符串值中引用,或用 ${name:-fallback} 附带默认值(未定义的名称回退到同名环境变量)。可以定义任意多个根路径。
自动下载。 任何文件参数都可以写成带本地 path 与一个或多个 urls(或单个 url)的对象。相对 path 以配置文件所在目录为基准解析。若 path 不存在,则从第一个可用 URL 下载(镜像按顺序尝试),保存到该路径,之后复用;进度打印到 stderr,可选的 sha256 只校验新下载的文件(已存在的文件直接使用)。命令行(或后出现的文件)也设置了同一参数的下载条目,会在解析之前被丢弃,因此不会为它下载任何东西——--mmproj none 可跳过配置中投影器的下载。
{
  "variables": { "modelRoot": "C:/models", "hf": "https://huggingface.co" },
  "backend": "ggml_cuda",
  "max-tokens": 256,
  "temperature": 0.7,
  "model": {
    "path": "${modelRoot}/Qwen3.5-9B-Q8_0.gguf",
    "urls": [ "${hf}/unsloth/Qwen3.5-9B-GGUF/resolve/3885219b6810b007914f3a7950a8d1b469d598a5/Qwen3.5-9B-Q8_0.gguf" ],
    "sha256": "809626574d0cb43d4becfa56169980da2bb448f2299270f7be443cb89d0a6ae4"
  }
}
开箱即用的示例见仓库 config/ 目录(cli-basic.json、server-basic.json、variables.json、auto-download.json、qwen-image-2.1.json)——每个都使用真实、公开、无需授权的 URL,因此在全新机器上也能直接运行。完整说明见 config/README.md。
命令行选项
不带任何参数运行 CLI —— 或使用 --help(也支持 -h、-?、/?)—— 会打印完整的参数参考:逐项列出说明、默认值、取值范围与示例,并在日志与模型机制启动之前退出。已列出的选项不区分大小写,也接受 --option=value 形式,与服务端一致;带了值的开关(--think=on)或后面没有值的取值参数属于配置错误(退出码 1)。未知参数会被忽略,因此请准确复制选项名,否则拼写错误也可能看起来执行成功。(服务端更严格:遇到未知选项会拒绝启动;若有相差不超过两处编辑的已知选项,还会提示它。)
输入 / 输出
| 选项 | 说明 |
|---|---|
--model <path> | GGUF 模型文件路径(必需)。 |
--input <path> | 包含用户提示词的文本文件。单次文本提示词只能来自文件;--prompt 保留用于图像与视频生成的提示词。 |
--pdf <path> | 单次模式的 PDF 文档输入。含文本的 PDF 会完整提取并内联文本;扫描件/纯图像 PDF 会光栅化为页面图像,并需要视觉模型 + --mmproj。--input 变为针对文档的问题;TS_PDF_MAX_PAGES 限制读取页数(默认:全部)。 |
--input-jsonl <path> | 含批量请求的 JSONL 文件(每行一个 JSON)。 |
--multi-turn-jsonl <path> | 用于带 KV 缓存复用的多轮对话模拟的 JSONL 文件。 |
--output <path> | 将生成文本写入此文件。 |
--image / --video / --audio <path> | 用于视觉 / 视频 / 音频推理的媒体文件(音频需要支持音频的模型,例如 Gemma 4)。--image 可重复。 |
--mmproj <path|none> | 多模态投影器:mmproj GGUF;对 Gemma 4 家族(包括 DiffusionGemma)也可以是存放视觉塔的 HuggingFace .safetensors 分片,用于没有发布 mmproj 的权重(diffusiongemma-26B-A4B-it)。none(不区分大小写)不加载投影器并跳过查找,与服务端一致。给出 --image、--audio 或 --video 却未给出该参数时,CLI 会在模型旁按各架构自己的伴随文件名查找——Gemma 4 为 gemma-4-mmproj-F16.gguf;Qwen 3.5 系列为 Qwen3.5-mmproj-F16.gguf(Bonsai2:Ternary-Bonsai-2-27B-mmproj-BF16.gguf / -Q8_0.gguf);Muse-Glimmer 为 *mmproj*Muse*Glimmer*.gguf;GLM-5.x 与 Qwen 3.8 Flash Next 为 *mmproj*.gguf;Mistral 3 为 mistral3-mmproj.gguf / *mmproj*istral*.gguf;Nemotron-H 为 *Nemotron*mmproj*.gguf / *mmproj*Nemotron*.gguf;DeepSeek V4.1 为 deepseek41.vision.gguf——而 .safetensors 视觉分片从不自动识别,其他情况请显式传入。 |
运行时
| 选项 | 说明 |
|---|---|
--max-tokens <N> | 最大生成 token 数(默认:100)。 |
--backend <type> | 计算后端:cpu、cuda、mlx、ggml_cpu、ggml_metal、ggml_cuda、ggml_vulkan(默认:ggml_cpu)。 |
--gpu-device <N> | ggml_vulkan 后端在多 GPU 主机上使用的 Vulkan 设备索引(默认:0;环境变量 TS_GGML_VULKAN_DEVICE)。 |
--list-gpus | 列出 ggml-vulkan 可见的 Vulkan 设备(索引 + 显卡名称)后退出。 |
--help | 打印完整参数参考(逐项列出说明、默认值、取值范围与示例)后退出;不带任何参数启动 CLI 时也会显示。 |
--kv-cache-dtype <type> | KV 缓存精度:f32、f16、q8_0 或 q4_0(默认:自动,由后端/模型选择;覆盖 KV_CACHE_DTYPE 环境变量)。块量化档位需要原生 GGML flash-attention 路径;q4_0(约为 f32 占用的 1/7)面向 128K–256K 的超长上下文。 |
--n-cpu-moe <N> / -ncmoe <N> | 把前 N 层的路由 MoE 专家权重留在系统内存中并在 CPU 上做乘法;注意力、归一化、路由器与共享专家仍留在加速器上。传 all 表示所有层。所有架构默认都是 0。DeepSeek V4 不再自行卸载:装不下的权重会在加载时被拒绝,并给出能装下所需的最少卸载层数。GLM 5.x 上,驻留主机的专家直接从 GGUF 映射中取用、不做私有拷贝(设 TS_GLM_MOE_MMAP=0 改为拷贝),并且这个开关能与 --tp 组合——驻留主机的层保留完整专家,由 rank 0 求值。在 Muse Spark 的原生执行器上,TS_MUSE_SPARK_CPU_MOE=auto 会覆盖它,改用逐层分别放置 gate、up、down 专家堆栈的方案,尽可能多地留在 GPU 上;两者都不设时,装不下的检查点会被拒绝,报错信息会点名该选项。它的原生 --tp N 把全部专家留在 GPU 上,并拒绝这个开关。它是让原本装不下的权重能加载起来的手段,而不是提速开关:GLM-5.2 上 --n-cpu-moe 30 把 pp2048 从 915.9 拉到 94.7 t/s,但把加载器能定下的上下文从 342,272 抬到 646,400 token。环境变量:TS_N_CPU_MOE。 |
--cpu-moe / -cmoe | --n-cpu-moe all 的简写(环境变量 TS_CPU_MOE)。 |
--cpu-moe-threads <N> | 主机侧专家矩阵乘的工作线程数。默认值取决于本进程实际可用的 CPU 并行度(已计入亲和性掩码与 cgroup 配额):不超过 2 个 CPU 时为 1,不超过 8 个时为减一,更多时取一半且上限 64;DeepSeek V4 / V4.1 与 GLM-5.x 的原生执行器在卸载专家后使用全部可用 CPU(GLM-5.x 在无 GPU 的运行中也是如此)。不要超过 cgroup 的 CPU 配额 —— ggml 的线程池在栅栏处自旋,超订会让吞吐直接崩塌。环境变量:TS_CPU_MOE_THREADS。 |
--interactive / -i / --chat | 启动交互式 REPL(见下文)。它默认采样而不是贪心解码 —— 见采样。 |
--system <text> / --system-file <path> | 从文本或文件设定系统提示。单次运行(无论是否带技能)、交互式 REPL 与 DiffusionGemma 都会使用它;JSONL 批处理模式不使用。 |
--think | 启用思考 / 推理模式(思维链)。 |
--tools <path> | 含工具 / 函数定义的 JSON 文件。 |
--skills-dir <path> · --skill <name> | Agent Skills:面向模型的说明文件夹所在目录,以及本次运行要选中哪些。模型所需的其余内容通过 CLI 自己应答的内置工具取回——完整参数见下方 Agent Skills。 |
--code-exec | 启用 TensorSharp 内置智能体代码工具。默认关闭;完整说明见智能体工作与代码执行。 |
--spec · --spec-type <name> · --draft-model <path> | 投机解码:由草稿器提议接下来的若干 token,主干用一次批量前向完成验证。默认关闭,且必须在模型加载之前出现在命令行上 —— 完整参数见下方的投机解码。 |
--dump-prompt | 渲染提示词 + 分词后退出(不生成)。 |
--tp <N> | 张量并行度,仅用于层内权重切分;默认 1,环境变量 TENSORSHARP_TP_DEGREE。模型与 GPU 后端必须支持此模式。与 --layer-split 互斥;不支持的请求在启动时失败。 |
--layer-split <N> | 支持按层切分的架构使用的本地 GPU 数;环境变量 TENSORSHARP_LAYER_SPLIT_DEGREE。整层放到不同设备,仅支持单节点;不能与 TP 或分布式 TP 参数组合。 |
--tp-node-id <N> | 多节点分布式张量并行中本节点的 0 起始编号。需与 --tp-peers 一起使用。 |
--tp-peers <list> | 集群中所有节点的 host:port 列表,逗号分隔(例如 192.168.1.10:9500,192.168.1.11:9500)。所有节点必须完全一致;端口没有默认值,且需在节点之间可达。 |
--no-prefix-cache | 关闭 Radix 前缀缓存(单次、交互式、JSONL 与技能/工具运行默认开启),同时关闭交互式系统/工具提示词预热;它也会设置 TS_SCHED_PREFIX_CACHE=0。CLI 只在内存中保留该缓存,重启后从冷状态开始。 |
--continuous-batching / --no-continuous-batching | 启用(默认)或禁用共享推理引擎中的分页注意力连续批处理。 |
--config <path> | 从 JSON 配置文件读取参数(命令行参数会覆盖它)。支持 ${变量} 与模型自动下载。可重复。 |
采样
单次与批处理运行默认为贪心解码:temperature 0、top-k 0、top-p 1.0、min-p 0、关闭惩罚、seed -1(与默认值匹配 Ollama 的服务端不同)—— 即下表所列默认值。交互式 REPL(-i / --interactive / --chat)则默认采样,因为贪心对话在长回答上会陷入重复:temperature 0.8、top-k 40、top-p 0.95、min-p 0.05、64 个 token 的惩罚窗口(重复惩罚保持 1.0),若 GGUF 自带 general.sampling.* 取值则以其为准。两种模式下,你显式传入的参数始终优先。
| 选项 | 说明 |
|---|---|
--temperature <f> | 采样温度(默认 0 = 贪心)。 |
--top-k <N> | Top-K 过滤(默认 0 = 禁用)。 |
--top-p <f> | 核采样阈值(默认 1.0 = 禁用)。 |
--min-p <f> | 最小概率过滤(默认 0 = 禁用)。 |
--repeat-penalty <f> | 重复惩罚(默认 1.0 = 无)。 |
--repeat-last-n <N> | 重复 / 存在 / 频率惩罚考虑最近多少个 token(默认 64;0 关闭历史惩罚,-1 使用全部历史)。拼写与服务端及请求字段 repeat_last_n 相同,因此一个配置键就能驱动两个宿主;原先 CLI 独有的 --penalty-last-n 已移除。 |
--presence-penalty <f> / --frequency-penalty <f> | 存在 / 频率惩罚(默认 0 = 禁用)。 |
--seed <N> | 随机种子(默认 -1 = 非确定性)。 |
--stop <string> | 停止序列(可重复)。 |
投机解码
默认关闭。草稿器提议接下来的若干 token,主干用一次批量前向完成验证;每个真正输出的 token 仍然取自主干的某一行,并由本次运行自己的采样器抽出,因此这纯粹是一条提速路径 —— 输出序列与普通解码得到的完全一致。它在 --input、--input-jsonl、--multi-turn-jsonl 与 --interactive 上都会生效,而且这些参数必须在模型加载之前出现在命令行上:--spec 正是让 glm-dsa 把约 3 GiB 的 NextN 层调入显存的那个开关(这同时也会挤占上下文的空间),而 --spec-draft 在加载时就决定了原生计算图缓存的大小。→ MTP / NextN · DSpark · docs/speculative_decoding.md
| 选项 | 说明 |
|---|---|
--spec / --no-spec | 开启 / 关闭投机解码 —— 对内嵌在主干 checkpoint 里的草稿器(GLM-5.2、GLM-5.3、Qwen 3.6 NextN),这是显式的开启开关,因为加载它们会把额外权重调入显存;用 --draft-model 指定的草稿器无需它即可生效,而 --no-spec 同样可以将其否决。在草稿块借用主干 LM head 的权重上(其中包括 GLM-5.2 与 GLM-5.3 —— 它们位于 blk.78 的完整 NextN 块自己并不带 nextn.shared_head_head.weight),--tp N>1 下不可用,投机只在单设备或显式 --layer-split N 放置模式(不启用张量并行)下生效。默认关闭;环境变量 TS_SPEC。 |
--spec-type <name> | 用哪种投机算法起草。auto(默认)使用权重自带的草稿器 —— 逐 token 的 NextN/MTP 头(内嵌于 Qwen 3.6、Qwen 3.8 27B、GLM-5.2 与 GLM-5.3;Gemma 4 的独立 assistant GGUF;Qwen 3.8 Flash Next 的共享 MTP GGUF),或块级草稿器(DeepSeek V4 DSpark、Muse-Glimmer 与 Qwen 3.8 的 DFlash / DFlash2)。draft-head 与 block 用于显式钉住其中之一。ngram 完全不需要训练权重:它在上下文里回找最近几个 token 曾经出现过的位置,把当时的后续内容提议出来。但它仍需要主干支持投机验证,因此无法在 GPT-OSS、Mistral 3 与 Hunyuan Dense 上运行;DeepSeek V4 / V4.1 与 Muse-Glimmer 只能通过各自的块级草稿器验证,因此只有用 --draft-model 加载了该草稿器时它才会运行;而 Nemotron-H 会拒绝所有投机方式。--spec-type 只选择算法 —— 开启 n-gram 要写 --spec --spec-type ngram;若没有 --spec 或 --draft-model(且未设置 TS_SPEC),它与 --spec-draft、--spec-pmin 都不会开启投机,启动时会警告投机保持关闭。环境变量:TS_SPEC_TYPE。 |
--spec-draft <N> | 每个投机步最多起草的 token 数。它同时在加载时决定原生计算图缓存的大小,因此必须与 --spec 写在同一条命令行上。取值 1–64,默认 8 —— 块级草稿器则默认取自己训练时的块大小,并会把取值压到该块大小(DSpark 为 5);环境变量 TS_SPEC_DRAFT。 |
--spec-pmin <f> | 低于该置信度就停止起草。这个数代表什么由算法自己定义,所以各算法各有默认值而不共用一个:逐 token 头为 0.15(其 top-10 logits 上的 top-1 概率),块级草稿器为 0.35(累积前缀概率,因此同一个数字要严格得多),n-gram 为 0(在那里它改为缩放所需的匹配长度)。调低会起草更远、回滚更多;调高则更早退回普通 decode。取值 0.0–1.0;0 也被接受,表示完全不设门限。环境变量 TS_SPEC_PMIN。 |
--draft-model <path> | 所有以独立文件发布的草稿器共用的 GGUF 参数 —— DeepSeek V4 的 DSpark 支持模块、Muse-Glimmer 与 Qwen 3.8 的 DFlash / DFlash2 草稿器、Gemma 4 的 gemma4-assistant 草稿头,以及 Qwen 3.8 Flash Next 的共享 MTP 头(GGML 后端)。由文件自身的 general.architecture 决定加载方式(操作者从不需要选择机制),而指定这个文件本身就是请求:它自己就会启用投机,无需 --spec(显式的 --no-spec 可将其否决)。块级草稿器必须在模型分层切分之前就驻留,且 DeepSeek V4 的 DSpark 只存在于 --backend cuda 与 ggml_cuda 上。DeepSeek V4.1 仅在 ggml_cuda / ggml_cpu 上接受 deepseek41-dspark 草稿器;这条路径属于实验性质,训练模型已在 ggml_cuda 双 GPU 按层切分下通过初步文本/图像 HTTP 检查;尚不构成通用质量或吞吐验证。DFlash / DFlash2 草稿器只用一张 GPU:在 --tp N > 1 下,CLI 会拒绝挂载它、打印警告并按标准解码服务。Qwen 3.6、Qwen 3.8 27B、GLM-5.2 与 GLM-5.3 把 NextN 块嵌在主干 GGUF 内,不需要这个参数 —— GLM-5.3 在 blk.78 上带的是完整的一块,没有额外文件要下载 —— 但在 Qwen 3.6 上只有保留了该块的 GGUF 才算数,请用像 unsloth/Qwen3.6-35B-A3B-MTP-GGUF 这样保留 MTP 的导出;官方仓库用同样的文件名发布的版本已经把这个块剥掉了。环境变量:TS_SPEC_DRAFT_MODEL。→ DSpark |
--spec --spec-type ngram 在完全不带草稿器的权重上也能跑 —— 前提是该家族的主干无需草稿器即可做投机验证(见上方 --spec-type)。它靠把上下文原样引用回来起草,因此在答案本就大半写在提示词里的场景上最强:摘要、改写、翻译、重复性结构化输出与 agent 循环。在 Qwen3.5-9B(Q8_0、ggml_metal、M5 Pro)上实测 45.2 tok/s,对比普通解码的 31.4(1.44×),且输出逐字节一致。
DiffusionGemma、基准测试与日志
| 选项 | 说明 |
|---|---|
--diffusion-steps <N> | DiffusionGemma 每块去噪步数(默认:48)。 |
--diffusion-seed <N> | DiffusionGemma 确定性采样器种子,也是 Qwen-Image-2.1 的噪声种子(默认:0)。Qwen-Image-2.1 编辑的噪声还取决于 --image 传入的图片,因此用画出某张图的种子去编辑它,不会从它自己的噪声重新开始。 |
--diffusion-blocks <N> | 块自回归画布数量(0 由 --max-tokens 推导)。 |
--image <path> / --prompt <text> / --output <path> | Qwen-Image-2.1:编辑用的参考图(可重复,按命令行顺序在提示词之前标记为 <image1>、<image2>……,提示词可以用标记指代它;省略 --image 即为生成)、提示词与输出 PNG(默认 generated.png,编辑时为 edited.png)。复用 --diffusion-steps(默认 40,步数蒸馏插件则为 4–8)/ --diffusion-seed。 |
--mask <path> · --mask-mode grayscale|alpha · --mask-invert · --mask-feather <px> · --mask-crop · --mask-crop-padding <px> | Qwen-Image-2.1 局部编辑:与第一张参考图同尺寸的蒙版选择可编辑像素,支持反选、向内柔化与可选区域裁剪。输出保留源图尺寸与保护像素。这些是 CLI 参数;服务端接收对应的每请求字段。语义与范围 → |
--keep-source-size | Qwen-Image-2.1 编辑:结果保持第一张 --image 的精确宽高,对编辑结果再次编辑时不会缩小。采样面积约为该图自身面积,至少 1 百万像素、至多自动面积,宽高比近似保持(二者都按 32 像素网格取整),结果再缩放回源图尺寸。不能与 --width/--height 同时使用。服务端接收对应的每请求字段 keepSourceSize,Web UI 与 TensorAgent 的每次编辑都会发送它。 |
--cfg <F> | Qwen-Image-2.1 true-CFG 引导尺度(省略则自动取 1.0,即每步一次 Transformer 预测,或取 --lora 插件的配方;<= 1 关闭负向分支)。 LTX 2.5 要求 CFG 1,不接受其他显式引导配方。 |
--negative-prompt <text> | Qwen-Image-2.1 负向提示词(默认为空,即无条件分支)。只有 --cfg 大于 1 时才会用到,否则不跑负向分支。 |
--qwen-image-vae / --qwen-image-vl / --qwen-image-mmproj <path> | 覆盖解析到的 Qwen-Image-2.1 伴随文件(专用 2.1 VAE / Qwen3-VL-8B 文本编码器 / Qwen3-VL-8B mmproj)。 |
--qwen-image-variant base|turbo | DiT GGUF 是哪一个 Qwen-Image-2.1 检查点(GGUF 不带元数据)。turbo 按 Qwen-Image-2.1-Turbo 公布的 8 步调度、CFG 1 采样,拒绝其他步数,也拒绝步数蒸馏 --lora 插件。不声明时,文件名含单词 turbo 即按 Turbo 处理,加载时会说明。用于其他模型时被拒绝。环境变量:TS_QWEN_IMAGE_VARIANT。 |
--lora <path> | Qwen-Image-2.1 或 MiniMax-H3(FL2VA)的 LoRA 插件:config/lora/ 中的 TensorSharp 插件配置 .json;Qwen-Image-2.1 还可直接用 LoRA .safetensors,可重复以叠加 Qwen-Image-2.1 插件。MiniMax-H3 只接受一份 minimax-h3-lora 配置——config/lora/minimax-h3-fl2v-turbo-8step.json 或 -4step.json——它把 --diffusion-steps、--flow-shift、--sampler 与 --cfg 锁定为自己的配方,Ref2VA 检查点会拒绝它。以不合并的方式叠加在量化 Transformer 之上。模型不接受的插件会在启动时、插件下载之前被拒绝;若 --config 仍需下载模型,其家族会在该下载完成后立即检查。→ Qwen-Image-2.1 插件 · MiniMax-H3 Turbo |
--lora-scale <f> | 前一个 --lora 的强度(乘以 alpha / rank)。默认:插件配置中的 "scale",否则为 1.0。MiniMax-H3 拒绝负强度:其 Turbo 调度是在强度 1 下蒸馏的(0 保留适配器的各项,但上投影因子为零)。 |
--lora-config <path> | 前一个 --lora 的伴随配置:TensorSharp LoRA 配置、PEFT adapter_config.json 或 VideoX-Fun pdd_config.json。除非给出 --diffusion-steps / --cfg,否则由 Qwen-Image-2.1 插件的配方提供步数、sigma 与 CFG;放在这里的 MiniMax-H3 插件配置必须指向前一个 --lora 的权重文件,其配方保持锁定。 |
--qwen-image-lora · --offload-cpu | 已移除,启动时(包括作为 --config 键时)会直接拒绝。两者只服务于早期的 Qwen-Image-Edit 流水线。--qwen-image-lora 由 --lora 取代;--offload-cpu 没有替代参数,因为 Qwen-Image-2.1 的 DiT 权重始终常驻。 |
--penalty-last-n | 已移除,启动时(包括作为 --config 键时)会直接拒绝(退出码 1)。它是 CLI 独有的重复惩罚窗口名:请改用 --repeat-last-n <N>,即两个宿主与请求字段 repeat_last_n 共用的拼写。 |
--paged-kv* · --paged-bench* · --paged-batching | 已移除,启动时(包括作为 --config 键时)会直接拒绝(退出码 1)。它们配置和基准测试的独立分页 KV 存储已删除:跨请求的提示词复用由引擎的 radix 前缀缓存提供(--no-prefix-cache),它的 TS_KV_* 变量同样会被拒绝。--paged-batching / --no-paged-batching 是 --continuous-batching / --no-continuous-batching 的第二种拼写。 |
--width <px> / --height <px> | Qwen-Image-2.1 的固定输出尺寸,须为 32 的倍数(默认 0 = 自动:生成为 2048×2048,编辑则取与第一张参考图宽高比一致、面积大致相同的尺寸)。 LTX 2.5 默认 1024×1024,宽高必须为 64 倍数。 |
--benchmark | 运行合成的 prefill/decode 吞吐基准。 |
--bench-prefill / --bench-decode / --bench-runs <N> | 合成的 prefill 长度、decode 长度与运行次数。 |
--bench-chunked · --bench-fixed-tokens | 让基准的 prefill 走服务端式的分块路径;用预先确定的 token 流计时 decode,不做主机侧贪心采样(便于与 llama-bench 式结果对比)。 |
--bench-random-tokens | 与 --bench-fixed-tokens 相同,但 prompt 与 decode 的 token id 从整个词表中均匀随机抽取,每次运行换一批(固定种子),与 llama-bench 的取法一致。适用于从磁盘读取按 token 查找表或专家的模型。 |
--bench-kvcache / --bench-kv-turns <N> | 多轮 KV 缓存复用基准(带缓存 vs 强制重置)。 |
--warmup-runs <N> | 计时前丢弃的前向次数(默认:0)。 |
--log-level <lvl> | trace、debug、info、warning、error、critical、off。仅限 CLI:服务端没有 --log-* 参数,改读 TENSORSHARP_LOG_LEVEL / …_LOG_DIR / …_LOG_FILE,CLI 也会把这些环境变量作为默认值。 |
--log-dir <path> / --log-file <0|1> / --log-console <0|1> | JSON 行文件日志的目录与开关。 |
视频生成(MiniMax-H3 · Wan 2.1 / 2.2)
以下参数在 --model 为视频生成 DiT(LTX 2.5、MiniMax-H3 或 Wan)时生效。--prompt 提供文本,--image 提供条件帧,--output 指定 MP4 文件名(默认 video.mp4;若扩展名写成 .png,则改为把各帧写成 PNG)。除非用 --diffusion-steps / --cfg 覆盖,去噪步数与引导强度都来自模型自身的配方;MiniMax-H3 Turbo 插件的配方不能覆盖,只能重复其取值。
| 选项 | 说明 |
|---|---|
--video-mode <mode> | 在拥有多种条件模式的模型上,决定如何解释传入的图像。默认:根据你传了什么自动推断。MiniMax-H3 接受 t2v(纯文本)、i2v(图像就是首帧,会被驱动起来)、fl2v(首帧与尾帧)与 ref(图像是新场景里的身份/外观参考)。i2v/fl2v 需要 fl2va 权重,ref 需要 ref2va —— 它们是不同的文件而不是开关。在 ref2va 上,单独的 --image 会被当作一个参考,因此只会附带一张图的客户端无需改动即可工作。 |
--width <px> / --height <px> | 输出画布。MiniMax-H3 会把给出的每个维度向上取整到 32 的倍数(VAE 的 16× 空间比乘以 2×2 的 patch)。未指定尺寸时,文生视频与 Ref2VA 参考按 640×384 运行(在 Ref2VA 权重上,单独的 --image 保持该面积、取图像的宽高比);i2v/fl2v 则按 MiniMax 发布的 768p 配方由第一个关键帧(只有末帧时用末帧)决定画布:保持其宽高比、短边 768 像素、不超过 768×1344 像素,每边取最接近的 32 的倍数 —— 3:2 照片为 1152×768,2:3 为 768×1152,4:3 为 1024×768,16:9 为 1344×768,方图为 768×768;宽高比限制在 1:4–4:1,超出部分居中裁掉。这两种模式保留关键帧的构图,放进 640×384 后全身照的人脸只有约 60 像素高,仅 VAE 编码再解码就已糊掉;配方画布能保住人脸,代价是每帧视频 token 为 640×384 的 2.4 倍(方图)到 4.2 倍(16:9 及更宽),注意力开销增长得更快,单次运行耗时会成倍增加。同时给出 --width 与 --height 会为所有模式(包括关键帧模式)固定同一尺寸;只传其中一个时,另一个按条件图像的宽高比推出。Wan 则对齐到它自己的 VAE 网格,并默认取官方配方的面积:TI2V-5B 为 1280×704,其余为 832×480。--ref-image 参考永远不会决定画布尺寸。 LTX 2.5 默认 1024×1024,宽高必须为 64 倍数。 |
--video-frames <N> | 输出帧数,会对齐到模型自身的时间网格 —— Wan 为 4k+1,MiniMax-H3 为 17k+5;在模型允许时 1 表示只出一张静态图。默认取模型自身的值(33,Wan2.2-TI2V 为 49;MiniMax-H3 为 22)。帧数同时决定注意力开销与 VAE 解码耗时,是仅次于权重选择的第二大杠杆。 LTX 2.5 默认 17 帧/24 fps,帧数必须遵循 8k+1。 |
--fps <N> | 保存的 MP4 的播放帧率(默认 16,Wan2.2-TI2V 为 24 —— 即模型的训练帧率)。它只改变播放速度,不改变计算量。以固定帧率训练的模型(MiniMax-H3,24 fps)会覆盖任何其他取值。 |
--end-image <file> | 尾帧条件图像,用于接受它的模型(MiniMax-H3 的首尾帧模式)。与 --image 一起使用时,片段会被引导为从这两帧开始并结束。 LTX 2.5 也支持尾帧时间引导。 |
--ref-image <file> | 参考条件模型(MiniMax-H3 Ref2VA)的参考图像:主体被保留,而镜头、背景与构图来自提示词。可重复,最多 9 个;提示词按位置以 <Picture 1>、<Picture 2>…… 引用它们。参考图只会被缩小并保持自身宽高比,因此输出尺寸仍由 --width/--height 决定。去噪开销是线性而且平坦的 —— 在 RTX 3080 Laptop 上(640×384、22 帧,从一个参考到八个参考),每个参考每步约 626 ms。但超过大约四个之后,主导开销就不再是去噪器,而是文本那一遍:每个参考会给提示词加上约 250 个视觉占位 token,并要穿过 Qwen3-VL 的全部 50 层做 prefill —— 所以在削减步数之前,先考虑用更少、更好的参考。 LTX 2.5 的普通图像列表成为均匀时间关键帧;ref 身份参考需要可选 Ingredients 适配器。 |
--ref-video <path> | 参考视频片段,可重复;提示词中以 <Video 1>、<Video 2>…… 引用。既接受视频文件,也接受一个帧目录;两种情况都会被重采样到模型自身的 24 fps 与画布。参考片段是 H3 代价最高的一类输入:一段 22 帧、448×320 的片段会在输出本身所需的 1680 个 token 之上再加 980 个条件 token,而且 VAE 必须先把这 22 帧全部编码完,第一步去噪才能开始。要给它配音轨请用 --ref-video-audio。 |
--ref-video-audio <file> | 与同一位置的参考视频配对的音轨 —— 第一个对应第一个 --ref-video,依此类推。之所以与 --ref-video 分开,是因为容器里的音轨无法通过帧解码器读取。想要一段无声的参考片段就省略它。支持 WAV、MP3 或 Ogg。 |
--ref-audio <file> | 独立的参考音轨,可重复;提示词中以 <Audio 1>、<Audio 2>…… 引用。会被重采样到音频 VAE 的 32 kHz 立体声,并截断到所生成片段的时长。 |
--no-audio | 在与视频联合生成音轨的模型(MiniMax-H3)上跳过音频解码,只要画面时可省下音频 VAE 的时间与显存。纯视频模型会忽略它。 |
--flow-shift <F> | FlowMatch timestep shift(默认 0 = 模型官方配方:Wan 2.2 为 5.0,A14B T2V 为 12.0;Wan 2.1 中 1.3B 模型的视频运行为 8.0,其余 ≤ 480p 为 3.0、更高为 5.0;MiniMax-H3 为 12.0,在 MiniMax-H3 Turbo 插件下为 6.0,且拒绝其他取值)。在带联合音频流的模型上,该 shift 只作用于视频流。 |
--sampler <name> | unipc(Wan 官方采样器;多步预测-校正,在相同步数下质量更好)或 euler。默认取模型自身的值 —— Wan 为 unipc,LTX 2.5 为发布方配方 euler_ancestral(在 LTX 上 euler 仅作为确定性 Euler 诊断选项)。MiniMax-H3 走自己的 flow-match Euler 调度,会忽略它;但在 Turbo 插件下,euler 以外的采样器都会被拒绝。 |
--negative-prompt <text> | 无分类器引导使用的负向提示词(默认为模型官方的负向提示词)。在 --cfg 1.0 下不会被用到,因为根本不跑负向分支 —— 所以它对步数蒸馏的 Wan 权重、以及 CFG 蒸馏的 MiniMax-H3 都没有作用。 |
--cfg-cache-stride <N> | 引导缓存:每 N 步才跑一次无条件 CFG 分支,其余步复用缓存的引导方向(前三步与最后一步始终重算)。50 步时,2 只跑 100 次前向中的 77 次(快 1.30×),3 跑 70 次(1.43×)。默认 0 = 关闭。它是一种近似 —— 需要对齐参考样本时请保持关闭;另外在 --cfg 1.0 下它没有意义,因为根本没有无条件分支可缓存。 |
--diffusion-steps <N> / --cfg <F> | 覆盖配方或自动识别到的蒸馏取值。在基础 Wan 权重上用 30 步替代 50 步,观感非常接近而开销少 1.7×。MiniMax-H3 经过 CFG 蒸馏:默认 20 步,任何高于 1.0 的 --cfg 都会被拒绝;在 Turbo 插件下它只按插件的 8 或 4 步采样,其他任何 --diffusion-steps 都会在启动时被拒绝。 |
--video-vae <path> | 视频 VAE —— wan_2.1_vae.safetensors,TI2V-5B 用 Wan2.2_VAE.safetensors,MiniMax-H3 用 minimax_h3_video_vae_fp16.safetensors。默认在 DiT 同目录扫描,包含 VAE/ 子目录。环境变量:TS_VIDEO_VAE。需要哪个 VAE 由 DiT 自己决定,而不是由你指定。 |
--video-text-encoder <path> | 文本编码器 GGUF —— Wan 用 UMT5-XXL,MiniMax-H3 用 Qwen3-VL-32B。默认在同目录扫描;环境变量 TS_VIDEO_TEXT_ENCODER。H3 的编码器不附带分词器 —— 请把 vocab.json 与 merges.txt 放在它旁边,或用 TS_VIDEO_TOKENIZER 指向存放它们的目录。 |
--video-dit2 <path> | 双专家模型的第二个扩散专家(Wan 2.2 A14B 的 high/low noise 一对)。默认按文件名在第一个专家旁边自动解析。环境变量:TS_VIDEO_DIT2。 |
--audio-vae <path> | 与视频联合生成音轨的模型所用的音频 VAE(minimax_h3_audio_vae_fp32.safetensors)。不传它这类模型照样能跑并产出视频,只是没有声音。环境变量:TS_VIDEO_AUDIO_VAE。 |
--video-upscaler <path> | 两阶段视频模型所用的 2 倍潜变量放大器:LTX 2.5 先以输出尺寸的一半生成,再用 ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors 放大潜变量,最后以完整尺寸精修。默认:模型同目录的 latent_upscale_models/。环境变量:TS_VIDEO_UPSCALER。 |
--video-diffusion-vae <path> | 可选的 LTX 2.5 扩散视频解码器(ltx-2.5-video-vae-bf16.safetensors):颗粒和闪烁更少、画面更干净,但比默认的卷积 --video-vae 更柔和。仅支持 MLX 和 CPU;CUDA 会拒绝。默认:关闭。环境变量:TS_VIDEO_DIFFUSION_VAE。 |
在视频家族中,Wan 可运行于 ggml_cuda、ggml_vulkan、ggml_metal、ggml_cpu、cuda 与 cpu —— 它是唯一会直接拒绝 --backend mlx 的模型族。Wan 与 MiniMax-H3 都没有多卡路径:不支持的 --tp N / --layer-split N 请求与分布式组均在加载时被拒绝。→ MiniMax-H3 实测数据 · Wan 后端耗时与成本模型
完整参考(含 --test、--test-templates 与分块 prefill 正确性检查)见 API 参考 页。
社区技能发现通过 find-skills 的 skills_search、skills_inspect 与 skills_install 工具完成,需要技能网络权限;不是独立的 HTTP 安装端点。服务端/应用可安装,默认 CLI 只读并提供搜索/检查。 条件与当前技能包 →
Agent Skills(智能体技能)
一个技能就是一份 SKILL.md 加上脚本、参考文档与素材。CLI 先展示名称与描述;对于能调用工具的模型,即使显式选中技能,启动时也只放元数据,模型决定使用后再通过 skills_read 读取说明。无法完成工具往返的家族才会把选中技能正文内联。→ 功能概览 · 通过 HTTP 使用 · 在 C# 中使用 · 智能体架构
| 选项 | 说明 |
|---|---|
--skills-dir <path> | 扫描 Agent Skills 的目录(可以是装着若干 SKILL.md 的文件夹,也可以是单个技能目录)。可重复;按给出的顺序扫描,最深三层。不传时,默认先使用从工作目录向上直到 Git 仓库根目录的每个已存在的 .agents/skills 目录(离得最近的优先;不在仓库内时只检查工作目录),再加上二进制文件旁的 skills 目录(不存在则创建)。个人技能目录绝不会被隐式加载。传入的路径不存在会在启动时报错并点名该参数。环境变量:TS_SKILLS_DIR(以路径分隔符分隔的列表);两者给出的显式目录都会取代上述默认值。 |
--skill <name> | 按 SKILL.md 中的名称为本次运行选中技能。可重复。选中会展示其元数据并允许读取;能调用工具的模型仍按需读取正文。 |
--list-skills | 打印技能注册表——名称、描述、来源、随包文件、大小,以及任何加载告警或错误——然后退出。 |
--no-skills | 彻底关闭 Agent Skills:不扫描、不注入提示词块、不提供工具。环境变量:TS_NO_SKILLS(非 0 即视为开启)。 |
--skills-no-discovery | 不向模型展示未被选中的技能。不加时,所有已注册技能的名称与描述都会列出,好让模型自己发现你没想到要点名的那个;加上后,本次运行只看得到 --skill 选中的技能。 |
--skills-allow-exec | 声明 skills_run,允许模型运行选中技能自带的脚本。默认关闭;这仍是任意代码执行。路径检查、解释器白名单、清洗环境、关闭 stdin、60 秒期限与 stdout/stderr 各 32 KiB 上限始终生效;OS 隔离由 --skills-sandbox 决定。环境变量:TS_SKILLS_ALLOW_EXEC。 |
--skills-sandbox <off|preferred|required> | 脚本隔离策略。默认 required,若无法约束写入、网络与主目录读取就拒绝;preferred 可在报告缺口后继续;off 只保留进程内限制。macOS 使用 Seatbelt,Linux 需要 bubblewrap 0.12+;Windows job object 无法约束文件或网络。环境变量:TS_SKILLS_SANDBOX。 |
--skills-allow-network | 允许技能脚本联网;默认禁止,并与代码执行的联网权限彼此独立。环境变量:TS_SKILLS_ALLOW_NETWORK。 |
--skills-max-rounds <n> | 内部模型 / 工具生成次数上限,范围 1–64。技能披露默认 8;提供 --code-exec 时自动提高到 24,但显式设置的值原样保留。环境变量:TS_SKILLS_MAX_ROUNDS。 |
# 查看注册了哪些技能、来自哪里,以及是否有加载告警
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --skills-dir ~/skills --list-skills

# 选中一个技能的一次性推理
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_metal \
    --skills-dir ~/skills --skill pdf --input prompt.txt --max-tokens 600

# 两个技能,且关闭发现:模型只看得到这两个,别的都看不到
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_cuda --skills-dir ~/skills \
    --skill pdf --skill xlsx --skills-no-discovery --input prompt.txt

# 交互式,并允许执行脚本(自己的机器、自己的技能)
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_metal --skills-dir ~/skills \
--skills-allow-exec -i同样的参数拼写在配置文件("skills-dir": ["/srv/skills"])和 TensorSharp.Server 上都成立,因此一份配置文件可以同时驱动两个宿主。多个目录按优先级顺序扫描(在服务端,上传目录排在最前);两个目录出现同名技能时以排在前面的为准,另一个会作为错误报告,而不是靠自动改名解决。在 REPL 里,/skills 与 /skill <name> 对单次会话起同样的作用——见交互式 REPL 命令。可直接取用的开源技能:github.com/anthropics/skills;完整参考见 docs/agent_skills.md。
技能属于不受信任的内容。模型点名的每条路径都经过词法、规范化与符号链接检查,一个技能不能读取另一个技能。脚本执行仍是运维的信任决定:默认要求沙箱,但 macOS 会开放共享的 /private/tmp,且无法保证清理故意脱离的子进程;Windows 必须改用 preferred 才会运行,因为 job object 无法约束文件或网络。不要在面向不可信用户的共享服务上为不可信技能开启它。
智能体工作与代码执行
--code-exec 启用有界的单助手模型 / 工具循环。TensorSharp 声明并执行四个内置工具:read_file、write_file、shell 与原子化的 apply_patch;通过 --tools 提供的调用方工具仍回传调用方处理。CLI 没有子智能体运行时 —— 委派给子智能体是服务端功能,并在服务端默认开启 —— 也没有逐命令审批提示;下列启动参数就是运维授权。→ 智能体工作
| 选项 | 说明 |
|---|---|
--code-exec | 提供全部四个内置工具。默认关闭;环境变量 TS_CODE_EXEC。没有持久工作区的直接调用方只能得到 shell,但 CLI 会话会保留工作区。 |
--code-exec-allow-install | 允许宿主代为执行 pip/npm 安装,写入会话共享环境。默认关闭;不会赋予生成命令联网权限。环境变量:TS_CODE_EXEC_ALLOW_INSTALL。 |
--code-exec-packages <list> | 识别出的宿主安装器可装的软件包白名单,逗号分隔;空表示任意合法包。命令联网后它不再是出口边界。 |
--code-exec-install-domains <list> · --code-exec-install-index <url> | 安装器可访问的主机(默认 pypi.org,files.pythonhosted.org,registry.npmjs.org),以及运维指定的软件包索引。 |
--code-exec-allow-network | 赋予模型生成命令不受限的宿主 IP 网络访问,包括 LAN / loopback 与监听 socket。默认关闭,并与安装权限、--skills-allow-network 相互独立。环境变量:TS_CODE_EXEC_ALLOW_NETWORK。 |
--code-exec-timeout <seconds> · --code-exec-max-output <bytes> | 单命令默认期限(120 秒;调用最多可请求 10 分钟)与从中间截断的输出上限(32768 字节)。 |
--code-exec-shell <path|name> | 覆盖自动检测到的 POSIX shell 或 PowerShell 程序。 |
--code-exec-temperature <0..2> | 可选的代码轮温度覆盖;只替换仍为默认值的温度。只要代码工具可运行,代码轮就会关闭内置的 1.1 重复惩罚,即使未设置此参数也是如此。 |
--code-exec-unconfined | 在 OS 隔离不足时仍显式运行。Windows 必须使用;切勿为不可信宿主用户开启。 |
--code-exec-languages | 已移除,启动时会直接拒绝。没有替代参数:shell 能访问每次重建的 PATH 上所有解释器,因此 TensorSharp 只报告已安装项,不再假装能实施语言白名单。 |
# 持久交互工作区;命令仍默认离线
dotnet run --project TensorSharp.Cli/TensorSharp.Cli.csproj -- \
    --model <model.gguf> --backend ggml_metal --code-exec -i
CLI 会在整段聊天中保留同一个工作区、当前目录、允许保留的导出环境状态与安装的软件包;技能脚本也与代码工具共用它。PATH 会在每次调用时刻意重建,因此靠修改 PATH 激活虚拟环境不会跨调用保留。每条命令仍是一个新的受约束进程。Linux bubblewrap 0.12+ 会约束写入、主目录读取、网络与后代进程;macOS Seatbelt 约束写入 / 主目录 / 网络,但会报告故意脱离的子进程可能比请求活得更久;Windows 只提供进程树限制,因此在 required 模式下拒绝执行。生成文件以本地路径报告。凡是能渲染工具声明并解析工具调用的家族都会得到代码工具,包括 Qwen 3.8 Flash Next(qwen4exp);Mistral 3、Hunyuan Dense 与 DiffusionGemma 不渲染工具声明,因此得不到代码工具。
交互式 REPL 命令
用 --interactive / -i 启动。任何不以 / 开头的内容都是一轮用户输入;输入 /help 查看列表。提示头显示当前模型、后端、架构、上下文长度、投影器、对话深度与待发送附件。生成时按 Ctrl+C 中断;在提示符处按 Ctrl+C 退出。
生成时引导:在单行交互模式中,回答生成时输入新的提示词并按 Enter,可中断当前回答并继续新一轮;已生成的助手文本保留在历史中。斜杠命令同样先停止并清理生成,再执行。多行输入在单独一行输入 . 后才提交;重定向输入按顺序执行完整回合并在 EOF 干净退出。此功能需要 v2026.10.10 后的构建。
对话
| 命令 | 说明 |
|---|---|
/help、/? | 显示所有交互命令。 |
/exit、/quit | 离开会话。 |
/reset、/new | 清空对话历史与 KV 缓存。 |
/history · /save <file> | 打印对话 / 将记录写入文件。 |
/system <text> | 设置系统提示(空参数会清除它)。 |
/think on|off · /multiline on|off | 切换推理模式 / 多行输入。 |
Agent Skills
| 命令 | 说明 |
|---|---|
/skills | 列出已注册的 Agent Skills,并标出本会话中哪些处于启用状态。 |
/skill <name> | 为本会话开启或关闭某个技能。与 /system 一样会重置对话——技能文本块位于提示词最前端。 |
模型与运行时
| 命令 | 说明 |
|---|---|
/info、/status | 显示已加载模型、后端、架构、上下文/词表大小、投影器、深度。 |
/model <path> | 在当前后端上加载另一个 .gguf(重置会话)。 |
/backend <name> | 在另一后端上重新加载当前模型:cpu、cuda、ggml_cpu、ggml_metal、ggml_cuda 或 ggml_vulkan。 |
/mmproj <path> | 加载或替换多模态投影器。别名:/projector。要卸载投影器需重新加载模型:/model <path>。 |
采样(实时)与上传(下一轮)
| 命令 | 说明 |
|---|---|
/sampling、/show | 打印当前采样配置。 |
/max · /temp · /topk · /topp · /minp | 设置回复长度 / 温度 / top-k / top-p / min-p。别名:/maxtokens、/temperature。 |
/repeat · /presence · /frequency · /seed | 设置惩罚与随机种子。 |
/stop <text> · /clearstop | 添加 / 清除停止序列。 |
/image <path> · /audio · /video · /text | 为下一轮附加媒体或内联一个文本文件。别名:/img、/vid,以及 /text 的 /file 与 /txt。 |
/clearattach | 丢弃待发送附件而不发送一轮。 |