服务器与 Web UI
TensorSharp.Server.Host(基于 TensorSharp.Server 库)是一个 ASP.NET Core 应用,托管单个 GGUF 模型,并在同一端口上暴露浏览器聊天 UI 以及兼容 Ollama 和 OpenAI 的 REST API。连续批处理引擎负责并发。
下方先给出聊天服务的首次运行;若目标是其他模型或协议,可直接选择嵌入、Jev、智能体或视频服务。全部参数保留在参考表中,可按需展开。
1. 启动本地服务器
快速开始(Gemma 4 E4B)
按平台安装 .NET 10 SDK、Git、CMake 与 curl,然后在终端粘贴下面的命令。请为 7.48 GiB 模型下载与首次还原/构建预留时间,耗时取决于网络与机器性能。它会通过原生 GGML 桥接托管示例使用的 Gemma 4 E4B Q8_0,使用推荐的公开 ggml-org 文件。下面的代码块面向 Linux + NVIDIA(CUDA 构建还需要 CUDA Toolkit):
独立服务器没有内置 API Key 身份验证。下面的命令使用 HTTP(没有 TLS),并显式绑定 127.0.0.1 供本机访问。省略 --host 时默认监听所有接口(0.0.0.0)。远程访问应经过主机防火墙与带身份验证的 HTTPS 反向代理;不要直接向不可信网络开放服务端口。
git clone https://github.com/zhongkaifu/TensorSharp.git
cd TensorSharp
TENSORSHARP_GGML_NATIVE_ENABLE_CUDA=ON dotnet build TensorSharp.slnx -c Release -p:TensorSharpSkipMlxNative=true
curl --create-dirs --fail -L "https://huggingface.co/ggml-org/gemma-4-E4B-it-GGUF/resolve/main/gemma-4-E4B-it-Q8_0.gguf?download=true" -o models/gemma-4-E4B-it-Q8_0.gguf
dotnet run --project TensorSharp.Server.Host -c Release --no-build -- --model models/gemma-4-E4B-it-Q8_0.gguf --backend ggml_cuda --host 127.0.0.1
Apple Silicon 请省略 CUDA 环境变量并使用 ggml_metal;受支持的 Windows/Linux Vulkan GPU 请改为请求 TENSORSHARP_GGML_NATIVE_ENABLE_VULKAN=ON 并使用 ggml_vulkan;没有受支持的 GPU 时可省略该环境变量并使用 ggml_cpu。占用内存更低的 gemma-4-E4B-it-Q4_K_M.gguf 位于同一仓库。纯文本不需要投影器;图像、视频或音频还需匹配的 mmproj-gemma-4-E4B-it-Q8_0.gguf,并通过 --mmproj 传入。Windows PowerShell 与完整平台语法见快速开始。
等待启动日志显示监听地址后,在第二个终端先检查存活与已加载模型,再发出一次聊天请求:
curl -sS http://127.0.0.1:5000/health
curl -sS http://127.0.0.1:5000/v1/models
curl -s http://127.0.0.1:5000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{"model":"gemma-4-E4B-it-Q8_0.gguf","messages":[{"role":"user","content":"Reply with one short hello."}],"max_tokens":32}'API 基址是 http://127.0.0.1:5000。内置 wwwroot/ 存在且启用时,GET / 会返回其中的 index.html 聊天界面。GET /health 始终返回存活响应 "TensorSharp.Server is running";这不检查模型是否就绪。Web UI 未启用或 index.html 不存在时,/ 才回退为同一个存活响应。
推理必须在启动时传入 --model。服务器只托管启动时指定的 GGUF,以及可选且必须显式传入的 --mmproj;它不会扫描模型目录或自动探测投影器。/api/models/load 只能用其他受支持后端重新加载同一启动组合。无模型进程不能在运行时选择 GGUF。默认监听地址是 http://0.0.0.0:5000;--port、--host 与 --urls(环境变量 PORT / HOST / ASPNETCORE_URLS)可以改变它。
已构建的源码目录
已有构建或其他后端?展开启动示例
构建完成后,从仓库根目录运行这些命令。它们会调用 TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll;该输出目录也包含复制好的原生库与 wwwroot/。Releases 页面也附带面向受支持平台的自包含 CLI 与服务器压缩包。
# Apple Silicon / Metal
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model ./models/model.gguf --backend ggml_metal --host 127.0.0.1

# NVIDIA / GGML CUDA
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model ./models/model.gguf --backend ggml_cuda --host 127.0.0.1

# AMD、Intel 或 NVIDIA / Vulkan;先查看设备索引
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --list-gpus
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model ./models/model.gguf --backend ggml_vulkan --gpu-device 1 --host 127.0.0.1

# 多模态:投影器始终显式指定
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model ./models/model.gguf --mmproj ./models/mmproj.gguf --backend ggml_cuda --host 127.0.0.1
2. 使用浏览器或 API
| 目标 | 下一步 | 需要区分 |
|---|---|---|
| 在浏览器中聊天 | 打开 http://127.0.0.1:5000/,再看界面功能。 | 需要启用并部署 wwwroot/index.html。 |
| 使用 OpenAI 兼容客户端 | API 基址为 http://127.0.0.1:5000/v1;见Chat Completions 与 Responses。 | 是否支持工具、思考与媒体取决于模型及端点。 |
| 使用 Ollama 兼容客户端 | 见Ollama 请求示例。 | /api/chat/ollama 是兼容路由;/api/chat 使用 Web UI 的 SSE 协议。 |
Web UI 功能
打开 http://127.0.0.1:5000/。浏览器界面支持:
界面功能、上传与生成流程
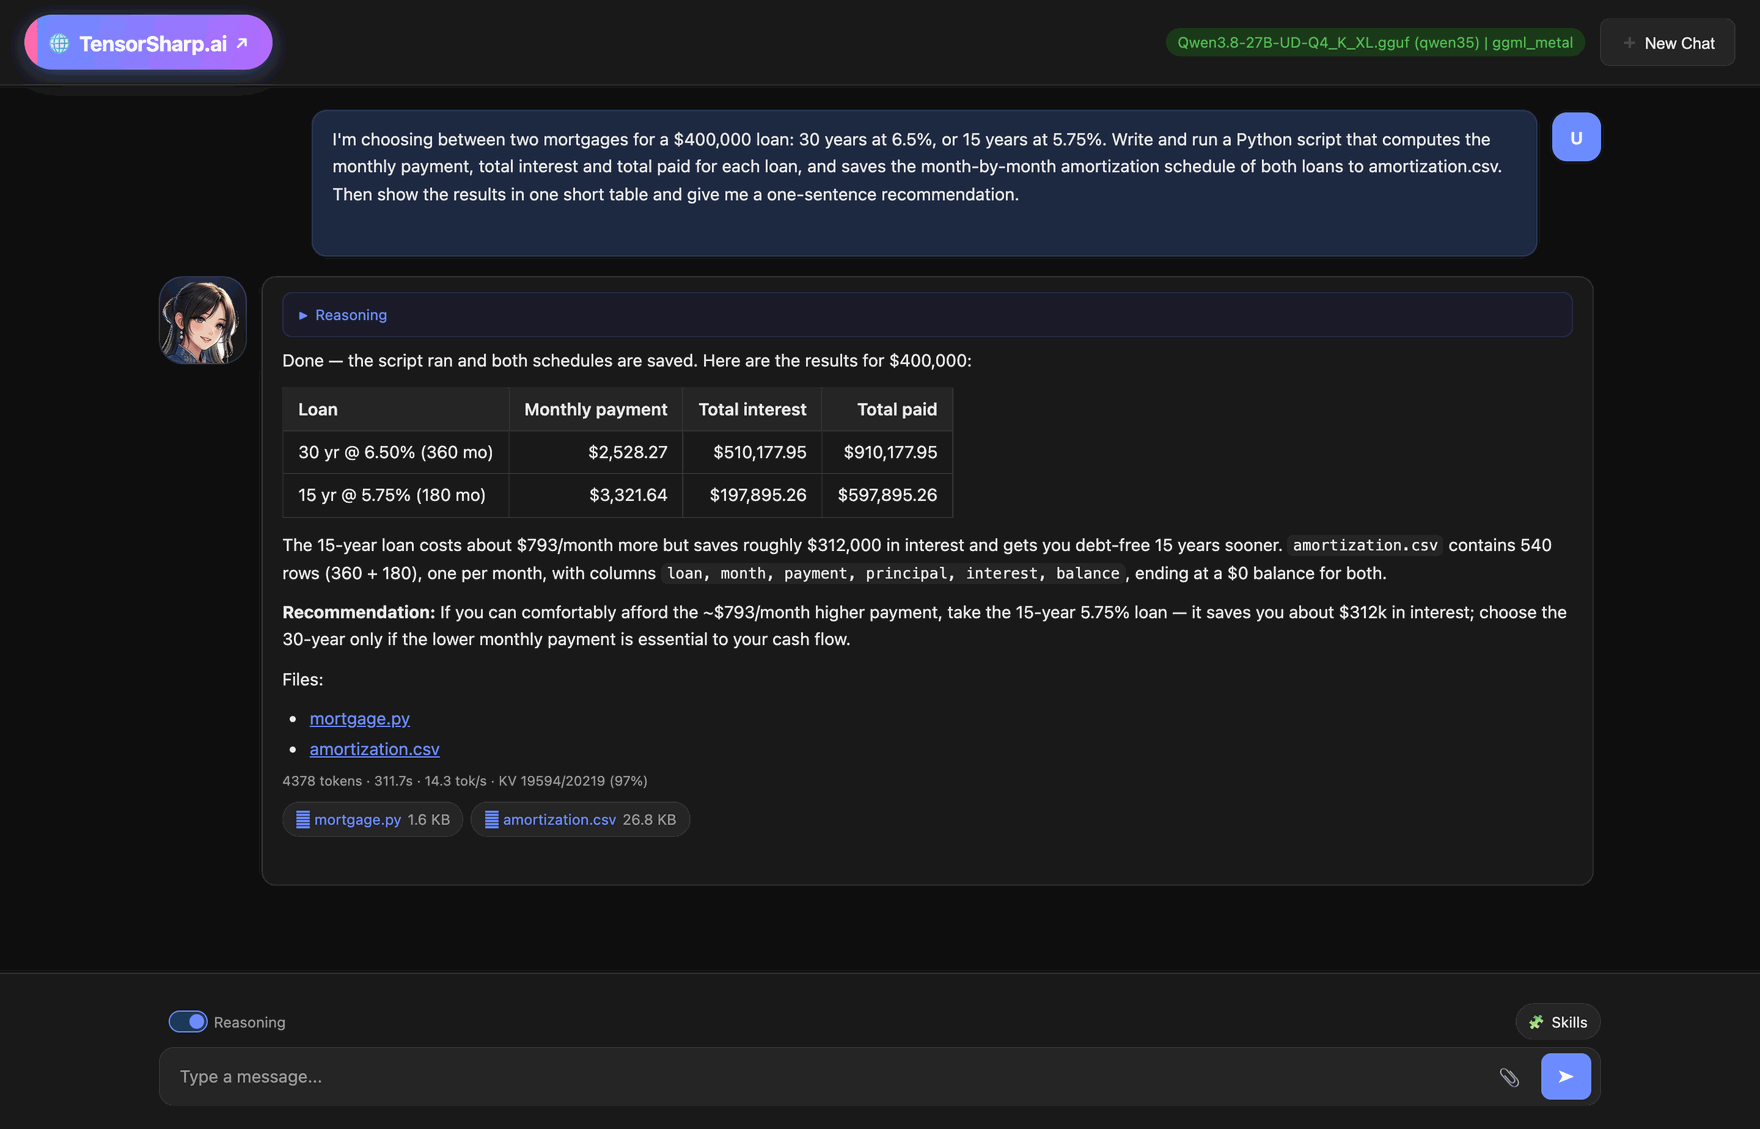
ggml_metal,以 --code-exec 启动,机器为 Apple M5 Pro。模型编写了 Python 脚本,在 macOS 沙箱中运行,核对两份还款计划都在余额 $0 处结束,用表格作答,并提供脚本和 540 行的 CSV 下载。- 多轮对话,带流式 token 生成(SSE)。
- 回答按 Markdown 渲染:表格、代码块、列表、标题与链接。页面把它们构建为元素,而不是把模型文本当作 HTML 解析,因此回复无法注入标记或脚本;链接只对
http(s)、mailto与服务器自身的文件下载保留目标地址。 - 每条回答下方的统计行:本轮生成的 token 数(包括推理与工具调用)、墙钟秒数、解码速度,以及提示词中有多少由 KV cache 提供。
- 每标签页独立的聊天会话 —— 每个标签页拥有自己的跟踪对话历史;请求 KV 块与前缀复用由推理引擎管理。
- 用于多模态推理的图像、视频、音频、PDF 与文本 / 代码上传(默认每个文件最大 500 MB;
--upload-max-mb调整单文件上限,POST /api/upload的请求体上限会随之调高——见下方上传选项)。 - PDF 文档:原生数字 PDF 会完整抽取文本层并内联到提示词;扫描 PDF 在视觉模型上回退为逐页图像(
TS_PDF_MAX_PAGES限制读取页数)。最终渲染的提示词会根据模型的实际上下文窗口进行检查。 - 思考 / 推理模式开关,以及带函数定义的工具调用。
- 智能体轮次的实时活动行;
wait_agent运行期间会出现可展开的wait_agent · N sub-agents列表,每个子智能体一张原位更新的卡片(任务、状态、当前工具、结果)。 - 消息编辑与删除,并可从对话中任意位置重新生成。
- 当托管
diffusion-gemmaGGUF 时,提供 DiffusionGemma 去噪预览(每步替换整条助手消息,最后定稿)。 - 托管
qwen_imageDiT 时提供 Qwen-Image-2.1:不带附件的提示词会生成图像,附加一张或多张图像则进行编辑;最多 8 帧实时去噪预览会原位刷新,最终 PNG 提供下载链接。浏览器不发送尺寸,因此两者都设置时输出使用--width/--height,否则使用模型的自动尺寸。 - 托管视频生成模型(LTX 2.5、MiniMax-H3 或 Wan)时提供视频生成:输入提示词,附上所加载权重声明支持的条件输入,浏览器通过 SSE 实时显示逐步去噪进度,直到 MP4 出现并提供下载链接。在 MiniMax-H3 上还会同时返回一条 32 kHz 立体声音轨 —— 它与画面出自同一次生成。所有数值仍然来自启动参数 —— 详见下文视频生成。
- 自由滚动 —— 在新 token 流式输出时阅读较早的回复;自动滚动会在回到底部时恢复。
选区图像编辑:附加照片,在编辑目标上选择选择区域,保存选区并描述修改。Qwen-Image 2.1 保持原始尺寸并保护选区外像素。结果提供比较原图与再次编辑;其他附加照片保留为参考图。选区编辑器与蒙版 API →
生成时引导回答
回答生成过程中输入并发送新消息,宿主会取消并清理旧生成,保留已产生的回答,再生成新一轮;单独的停止按钮仍可取消。此功能需要 v2026.10.10 后的构建。
个人知识库
启动前设置 TS_KNOWLEDGE_DIRECTORY,启用 /api/knowledge 存储与管理 API。支持的聊天请求显式传入 knowledgeCollections;缺失或空选择不检索。独立服务器 Chat 页面没有 TensorAgent 的知识库管理面板,应使用 API/SDK。TensorAgent 应用另有集合、文件夹和聊天导入界面。配置、支持路由与限制 →
3. 配置与运维
先固定可工作的本地启动方式,再把配置、访问边界与存储策略写进部署。选项表、环境变量与调度器参数保留完整细节。
- 访问边界:示例只绑定回环地址;跨机器访问前配置身份验证、HTTPS 反向代理与防火墙。
- 进程与模型:
/health是存活检查;用/v1/models和一次有界推理请求确认模型服务。--no-webui仅关闭界面,API 与/uploads仍可用。 - 日志与状态:通过
TENSORSHARP_LOG_DIR、TENSORSHARP_UPLOAD_DIR和TENSORSHARP_PREFIX_CACHE_DIR选择持久目录。--no-prefix-cache会关闭运行时前缀复用、启动提示准备和跨启动持久化。
配置文件(--config)
配置优先级、变量与自动下载
可以用 --config 传入一个 JSON 文件,取代冗长的命令行;CLI 读取相同格式。命令行参数始终优先——命令行自己设置了某个单值参数时,文件中该参数的条目会在解析之前被丢弃(不展开、不替换其中的变量、也永远不会发起其下载),因此可以在多台主机上复用同一个文件,只覆盖需要变化的部分。每个被覆盖的参数会在 stderr 上打印一行 [config] --X is set on the command line, so the value from '<file>' is ignored …。--gpu-device 与 --kv-cache-dtype 同样如此。--config 可重复以叠加多个文件(后出现的文件中的条目以同样方式取代先前的条目)。--skills-dir 由获胜来源替换整份根目录列表,获胜来源内部的重复值保留。会累加的参数——--stop、--skill、--lora、--lora-scale、--lora-config、--image 与各个 --ref-* 输入——则保留文件中的值并把命令行的值追加在后面。允许注释与尾随逗号。
# 从文件读取参数;绑定回环地址,并按主机覆盖后端
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --config config/server-basic.json --host 127.0.0.1
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --config config/server-basic.json --backend ggml_cpu --host 127.0.0.1
键名与下方长选项名相同(可带或不带前缀 --)。字符串/数字展开为 --key value,true 展开为裸开关 --key,数组展开为重复的标志(如 "stop": ["</s>", "<|eot|>"])。false 与 null 不产生任何参数,因此要关闭默认开启的选项,请写它的否定形式("no-continuous-batching": true)。lora-scale 与 lora-config 不能写成数组,已移除的选项作为键也会被拒绝。由于服务端会拒绝未知选项,仅 CLI 使用的键(如 interactive 或 input)会让它在启动时报错;惩罚窗口在两个宿主上都叫 repeat-last-n。
变量。 在 "variables"(别名 "vars")中定义一次共享值,用 ${name} 在任意字符串值中引用,或用 ${name:-fallback} 附带默认值(未定义的名称回退到同名环境变量)。可以定义任意多个根路径——位于不同目录的模型各用一个。
自动下载。 任何文件参数都可以写成带本地 path 与一个或多个 urls(或单个 url)的对象。相对 path 以配置文件所在目录为基准解析。若 path 不存在,则从第一个可用 URL 下载(镜像按顺序尝试),保存到该路径,之后复用;进度打印到 stderr,可选的 sha256 只校验新下载的文件(已存在的文件直接使用)。命令行(或后出现的文件)也设置了同一参数的下载条目,会在解析之前被丢弃,因此在命令行上传 --mmproj none 既会停用已配置的投影器,也会跳过它的下载。
{
  "variables": { "modelRoot": "C:/models", "repo": "https://huggingface.co/unsloth/gemma-4-E4B-it-GGUF/resolve/bfc15c382204943c3a8fff0c750b94ae2364d7a3" },
  "backend": "ggml_cuda",
  "max-tokens": 4096,
  "continuous-batching": true,
  "stop": ["</s>", "<|eot|>"],
  "model":  { "path": "${modelRoot}/gemma-4-E4B-it-Q8_0.gguf", "urls": [ "${repo}/gemma-4-E4B-it-Q8_0.gguf" ] },
  "mmproj": { "path": "${modelRoot}/gemma-4-E4B-mmproj-F16.gguf", "urls": [ "${repo}/mmproj-F16.gguf" ] }
}
开箱即用的示例见仓库 config/ 目录(cli-basic.json、server-basic.json、variables.json、auto-download.json、qwen-image-2.1.json)——每个都使用真实、公开、无需授权的 URL,因此在全新机器上也能直接运行。完整说明见 config/README.md。
服务器级默认采样
默认采样与请求覆盖规则
默认值会填补请求未提供的任何字段。开箱即用的默认值与 Ollama 一致:temperature 0.8、top-k 40、top-p 0.9、min-p 0、在最近 64 个 token 上的重复惩罚 1.1、存在/频率惩罚 0、seed -1。你显式配置过的参数还会覆盖客户端为其发来的值 —— 很多聊天客户端(如 VS Code Copilot Chat)会把 temperature/top_p 硬编码进每一次请求。加上 --sampling-precedence request 可把控制权交还给客户端。
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --model ./models/model.gguf --backend ggml_metal --host 127.0.0.1 \
    --temperature 0.7 --top-p 0.9 --top-k 40 --repeat-penalty 1.1 \
    --presence-penalty 0.0 --frequency-penalty 0.0 --seed 42 \
    --stop "</s>" --stop "<|endoftext|>"
上传与保留策略
| 边界 | 默认行为与配置 |
|---|---|
| 单文件 | 默认 500 MB;--upload-max-mb 控制 multipart 上传与解码后的 base64 附件。 |
| HTTP 请求体 | POST /api/upload 跟随单文件上限且不低于 500 MB。其他路由仍为 500 MB;base64 约膨胀三分之一,因此 JSON 内的文件在扣除其他字段前已限于约 375 MB。 |
| 总预算 | --upload-quota-mb 默认关闭;生成的图像与视频计入总量,超额请求在模型工作前拒绝。 |
| 保留时间 | --upload-ttl-hours 默认关闭,因为会话会引用附件路径。TENSORSHARP_UPLOAD_DIR 移动默认的二进制旁 uploads/ 目录。 |
按任务选择服务模式
按任务选择对应的模型与协议。嵌入与 Jev 已有完整指南;下方保留宿主侧限制,视频与工具细节按需展开。
嵌入服务指南 · Jev API · 智能体与工具 · 视频模型与下载
嵌入服务
编码器、媒体投影器与后端范围
使用 --model encoder.gguf --embeddings 托管 Snowflake、MiniLM 或 EmbeddingGemma 2。POST /v1/embeddings 与 POST /api/embed 返回归一化向量;EmbeddingGemma 2 配合 --mmproj 还支持图像/音频/视频与混合内容序列。后端与验证范围依模型而定。 配方、API 与验证 →
Jev 类型化决策
Jev 请求、别名与工作量上限
托管一个 DiffusionGemma GGUF(例如使用 config/jev-diffusiongemma-q4.json),POST /v1/systemone 就会应答与 Jev 兼容的类型化决策请求:请求体携带状态与类型化问题(noul、choice、score),响应返回在一次去噪步之后读出的概率、选项与期望分数。model 可以写已加载模型的名称,或别名 jev-latest / jev-preview(它们不是独立的权重)。请求只接受 JSON;用 --mmproj 加载视觉塔后,请求还可以在 images 数组中内联最多 8 张图像(base64 或 data: URL)。TS_JEV_MAX_BODY_MB(默认 8,1–64)、TS_JEV_MAX_CANVAS(默认 64,8–4096)与 TS_JEV_MAX_PENDING(默认可接纳 32 个请求,1–1024)限定工作量。字段、限制与状态码 →
Agentic Work 与代码执行
工具、子智能体与隔离边界
在能够完整往返工具调用的模型家族上,服务器让已加载的模型在进程内执行「生成 → 工具 → 再生成」循环。Agent Skills 可以在不执行脚本的情况下被发现与读取;运维者需另行传入 --skills-allow-exec 才允许运行技能自带脚本。--code-exec 则显式开启由宿主处理的 read_file、write_file、apply_patch 与沙箱化 shell 工具。Web UI 聊天会话会在各轮之间保留私有工作区;无状态 API 请求各自获得隔离的请求工作区,并在结束后删除。
同一个模型还可以委派任务:在 /v1/chat/completions、/v1/responses、/api/chat/ollama 与 Web UI 的 /api/chat 上,对能渲染工具声明并解析工具调用的家族(Mistral 3、Hunyuan Dense 与 DiffusionGemma 除外),子智能体委派默认开启。是否调用 spawn_agent、wait_agent、send_input、close_agent 与 list_agents 由模型决定;它既不依赖技能,也不依赖 --code-exec。每个子智能体都是同一模型上的独立对话,拥有自己的 KV 状态副本;explorer 与 reviewer 子智能体只读。--no-multi-agent 可关闭委派,下方的 --agents-* 选项为它设定上限,请求也可以用 "multi_agent": false 退出。项目没有发布它的延迟或质量测量数据。→ 子智能体
执行类工具在运维者开启前保持关闭,但一旦开启,系统不会再逐条命令弹出审批。沙箱模式默认是 required,无法安全隔离时直接拒绝:macOS 使用 Seatbelt,Linux 要求 bubblewrap 0.12.0 或更新版本。Windows Job Object 只能约束后代进程,不能隔离文件系统或网络,因此技能脚本需要显式选择更弱的沙箱模式,而模型生成的命令需要 --code-exec-unconfined。同一请求的子智能体树中,宿主工具调用一次只执行一个;worker 子智能体只有在 --agents-allow-worker-tools 下才能使用父智能体的可写工具。完整参数、模型家族限制、工作区生命周期与安全边界见 Agentic Work、Skills 与沙箱。
视频生成:网页界面能设什么,什么只能靠 API
模型配方、启动参数与逐请求视频字段
LTX 2.5: 使用 --config config/ltx-2.5-distilled.json;NVIDIA 用 cuda/ggml_cuda,Apple 用 mlx/ggml_metal(实际为 MLX),CPU 别名选择直接 CPU。默认 1024×1024×17、24 fps,宽高为 64 倍数、帧数 8k+1;8 步半尺寸加 3 步精修,CFG 1。 五文件、音频、条件与限制 →
托管一个视频生成模型(LTX 2.5、MiniMax-H3 或 Wan),网页界面就变成了一个视频生成器。这些接口判断的是 IVideoGenerationModel 接缝而不是架构字符串,因此其他模型会返回 400 与 The loaded model is not a video-generation model.。有必要清楚地知道浏览器实际控制了请求中多小的一部分:一次视频任务可能跑几分钟,也可能跑几小时,而浏览器在任务开始后无法再改变这一点。
# MiniMax-H3:画面与它的 32 kHz 立体声音轨在同一个潜变量里一起去噪。
# 不设尺寸参数:文生视频为 640×384,上传的关键帧按 MiniMax 的 768p 配方决定画布;
# --video-width/--video-height 会把所有模式固定为同一尺寸
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --host 127.0.0.1 \
    --model ./models/minimax_h3_fl2va_pruned-Q4_K.gguf --backend ggml_cuda \
    --video-steps 20 --video-frames 22

# 换另一个权重:用身份 / 外观参考生成一个新场景,尺寸为 640×384
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --host 127.0.0.1 \
    --model ./models/minimax_h3_ref2va_pruned-Q4_K.gguf --backend ggml_cuda \
    --video-steps 20 --video-frames 22
FL2VA 与 Ref2VA 是关键帧和参考模式各自使用的独立检查点。唯一配置 config/minimax-h3-fl2va.json 会下载两者、共享的 Qwen3-VL-32B 编码器、两个 VAE 和固定版本的分词器。模型按请求切换去噪器,/api/models 会报告可用模式。配置把输出尺寸交给对应工作流;手动安装分词器时可设置 TS_VIDEO_TOKENIZER。
要让 FL2VA 按 LightX2V 的 8 步或 4 步 Turbo 配方提供服务,加上它的插件配置即可。此后每段片段都按插件的调度采样,所以请不设 --video-steps(或设为插件的步数),请求也不要带 steps,与 Web UI 一样:与之冲突的 --video-steps 会在下载任何文件之前终止启动,冲突的请求返回 400(流式路由则是 {done, error} 事件)。权重(1.38 GB)在首次使用时下载;4 步配方为推断所得。→ Turbo 插件
dotnet TensorSharp.Server.Host/bin/TensorSharp.Server.Host.dll --config config/minimax-h3-fl2va.json --host 127.0.0.1 \
--lora config/lora/minimax-h3-fl2v-turbo-8step.json浏览器发送的是提示词,外加所加载模型声明支持的条件输入 —— 首帧、尾帧,或最多 maxReferenceImages 张参考图,以及随附的参考片段与音轨 —— 这份请求体是按 GET /api/models 返回的 video 能力对象拼出来的,而不是靠架构名去猜。帧数、fps、分辨率、去噪步数、seed、flow shift、采样器、负向提示词与引导缓存都没有在界面上暴露:它们来自启动参数或模型自身的配方。引导则根本没有对应的启动参数 —— 服务端完全没有 --cfg —— 只能在请求里设置,而 MiniMax-H3 会拒绝任何大于 1.0 的取值,因为它出厂就是 CFG 蒸馏过的。若要按请求设置这些值,请直接调用 POST /api/video-generate 或 /v1/videos/generations。
进程在启动时就已决定的部分:
| 由什么决定 | 设置项 | 说明 |
|---|---|---|
--model(进程内固定) | 属于哪个家族,以及去噪前向次数 | 最大的单项成本因素。MiniMax-H3 经过 CFG 蒸馏,每一步都只是一次无引导前向 —— 默认 20 步;它的步数蒸馏调度来自插件,而不是另一个权重(见下一行)。基础的 Wan2.2-TI2V-5B 走官方配方 50 步 × 2 次 CFG = 100 次 DiT 前向;步数蒸馏的 Turbo / Lightning / FastWan 权重会从文件名被识别出来,只跑 4 次无引导前向。在 M5 Pro 上、1088×832 × 121 帧的同一个请求,这就是约 3 h 30 m 与 17 m 30 s 的差别。→ H3 实测 · Wan 实测 · 下载 |
--lora <插件>(进程内固定) | MiniMax-H3 的步数蒸馏调度 | FL2VA 检查点的 LightX2V Turbo 插件——config/lora/minimax-h3-fl2v-turbo-8step.json 与 -4step.json——让每段片段按锁定的配方只跑 8 或 4 次无引导前向,而不是 20 次(4 步配方为推断所得)。Ref2VA 不接受它们。尚无 Turbo 片段的耗时记录。 |
--video-width N / --video-height N | 默认输出尺寸 | 服务端最主要的画质杠杆,因为网页界面自己不发送尺寸:不设它们,每段视频都按模型默认尺寸生成。MiniMax-H3 建议两个都不设:文生视频与参考为 640×384,图生视频与首尾帧按 MiniMax 的 768p 配方由第一个关键帧决定画布(3:2 照片为 1152×768,16:9 为 1344×768)。这两种模式保留关键帧的构图,在 640×384 下远景人物的脸会糊掉;配方尺寸要多花数倍时间。两个都设会对所有模式(包括关键帧)固定同一尺寸,并关闭 Studio 的“按首帧(模型推荐配置)”尺寸;只给出宽高之一时,H3 会按条件图像的宽高比推出另一个。别名:--width / --height。 |
--video-steps N | 默认去噪步数 | 分辨率之后第二重要的质量/耗时取舍。MiniMax-H3 默认 20 步;16–24 步明显更干净,超过约 30 步收益很小,更少的步数则来自 Turbo 插件(见上一行)。请求中的 steps 会覆盖它;在 Turbo 插件下两者都必须不设或等于插件的步数,否则会被拒绝(启动时拒绝,或返回 400)。 |
--video-mode <mode> | 默认条件模式 | 为未带 videoMode 的请求钉住 t2v / i2v / fl2v / ref。不传它,每个请求会按自身携带的内容推断模式,通常这才是你想要的;只提供单一模式的部署才需要钉住它。 |
--video-frames N | 默认帧数 | 这是服务端范围的默认值,不是上限:请求里带 frames 就会覆盖它。数值会对齐到模型自身的时间网格 —— Wan 为 4k+1,MiniMax-H3 为 17k+5。不传该参数时按模型配方来 —— Wan2.2-TI2V 为 49 帧,其余 Wan 权重为 33 帧,MiniMax-H3 为 22 帧。 |
--fps N | 默认播放帧率 | 同样是默认值,可被请求中的 fps 独立覆盖。不传时配方给出 Wan2.2-TI2V 24 fps、其余 16 fps;MiniMax-H3 以固定 24 fps 训练,会覆盖任何其他取值。fps 只改变播放速度,不改变计算量。 |
--audio-vae <path> | 是否会返回音轨 | 只对与视频联合生成音频的模型有意义(minimax_h3_audio_vae_fp32.safetensors)。不传它,MiniMax-H3 照样能跑并产出视频,只是没有声音 —— 而 /api/models 上的 supportsAudio 会报 false。 |
| 请求本身(仅 API) | 其余全部 | width、height、frames、steps、cfg、cfg2、seed、fps、flowShift、sampler、negativePrompt、cfgCacheStride、videoMode、generateAudio、endImage、referenceImages、referenceVideos、referenceAudios、referenceVideoAudios。 |
Web UI 形态的接口按上述 JSON 字段名接收参数;同一个请求体在 /api/video-generate(返回一个 MP4)与 /api/video-generate/stream(SSE 去噪进度)上都可用。视频生成在进程内串行执行,同一时刻只跑一个任务:
curl -s http://127.0.0.1:5000/api/video-generate \
  -H "Content-Type: application/json" \
  -d '{
        "prompt": "a red fox trotting through falling snow, cinematic",
        "width": 640, "height": 384,
        "frames": 22, "fps": 24,
        "steps": 8, "cfg": 1.0, "seed": 42,
        "videoMode": "t2v",
        "generateAudio": true
      }'
返回体是 { ok, url, audioUrl, width, height, frames, fps, seed, codec, elapsedSeconds };audioUrl 指向旁挂的 WAV,当模型没有产出音轨时为 null。Wan 使用同样的请求体,只是换成它自己的旋钮 —— "flowShift": 5.0、"sampler": "unipc"、"negativePrompt"、"cfgCacheStride": 2 —— 这些 MiniMax-H3 一个都不需要,因为它在 "cfg": 1.0 下无引导运行(在 Turbo 插件下,与插件不同的 flowShift 或 sampler 会被拒绝)。
"image" 字段可直接携带 base64 条件帧(允许带 data:…;base64, 前缀);"imagePath"、"endImage" 以及每一个 reference* 条目都是 Web UI 使用的形式,必须引用 /api/upload 已经返回过的文件 —— 任何解析到上传目录之外的路径都会被拒绝。OpenAI 形态的 POST /v1/videos/generations 接收同样的参数,但尺寸写作 "size": "832x480"、负向提示词写作 "negative_prompt"。完整的请求/响应结构见 HTTP API 页。
开跑长任务之前,先估算规模。开销主要由 DiT token 数决定(latent_frames × (h/2) × (w/2)),而自注意力是 O(token²),因此帧数与帧面积的影响远大于步数。在 MiniMax-H3 上的顺序是分辨率、帧数、步数 —— 它本来就不用引导,唯一的蒸馏杠杆是 Turbo 插件(仅 FL2VA),只跑 8 或 4 次前向而不是 20 次。在 Wan 上:换用步数蒸馏权重、减少帧数、减小帧面积(但不要低于约 0.3 MP)、在基础权重上减少步数,最后是 "cfgCacheStride": 2 或 3(1.30× / 1.43×)。480p(约 0.4 MP)是 Wan 训练过的分辨率,属于真正的输出档位,而非降级模式。
完整参考
展开需要的表格;键盘可聚焦并切换每个摘要。
服务器选项
全部服务器选项与行为
选项不区分大小写,也接受 --option=value 形式。与 CLI 不同,服务端遇到未知选项或多余的位置参数会拒绝启动;若有已知选项与之相差不超过两处编辑,还会提示最接近的那个。
| 选项 | 说明 |
|---|---|
--model <path> | 要托管的 GGUF 文件(推理必需)。 |
--mmproj <path|none> | 显式多模态投影器:mmproj GGUF;对 Gemma 4 家族(包括 DiffusionGemma)也可以是存放视觉塔的 HuggingFace .safetensors 分片(diffusiongemma-26B-A4B-it 没有发布 mmproj)。只写文件名时相对于模型目录解析;传 none 可禁用。需要 --model;不会自动扫描投影器。 |
--embeddings · --embedding-threads <N> · --embedding-context-size <N> | 托管 GGUF 嵌入编码器而不是聊天模型(见嵌入服务);需要 --model。Snowflake/MiniLM 支持 cpu、ggml_cpu、ggml_metal 与 ggml_cuda;EmbeddingGemma 2 还实现了直连 cuda/mlx,并可通过匹配的 --mmproj 接收媒体。Vulkan 嵌入尚未实现;实现可用不代表所有后端的媒体质量或性能已验证一致。生成类路由(聊天、Responses、Ollama、/v1/systemone,以及 /api/image-generate、/api/image-edit、/api/video-generate 与它们的 /stream 形式)返回 400 This server hosts an embedding model. Use /v1/embeddings or /api/embed.;显式指定本机没有的 --backend 时以退出码 2 结束,并打印 error: model load refused: Backend 'X' is not supported on this machine.。后两个参数设置编码器的 CPU 线程数与每条输入的最大 token 数,且需要 --embeddings。 |
--backend <type> | 默认后端:cpu、cuda、mlx、ggml_cpu、ggml_metal、ggml_cuda、ggml_vulkan(默认:macOS 上为 ggml_metal,其他平台为 ggml_cpu;环境变量 BACKEND)。 |
--tp <N> | 张量并行度,仅用于层内权重切分;默认 1,环境变量 TENSORSHARP_TP_DEGREE。模型与 GPU 后端必须支持此模式。与 --layer-split 互斥;不支持的请求在启动时失败。 |
--layer-split <N> | 支持按层切分的架构使用的本地 GPU 数;环境变量 TENSORSHARP_LAYER_SPLIT_DEGREE。整层放到不同设备,仅支持单节点;不能与 TP 或分布式 TP 参数组合。 |
--tp-node-id <N> / --tp-peers <list> | 加入多节点 TP 集群:本节点的 0 起始编号,以及所有节点共享且顺序一致的 host:port 列表。服务端只能是节点 0(负责采样并对外提供 HTTP 的 driver);其余节点运行 TensorSharp.Cli worker。 |
--gpu-device <N> | ggml_vulkan 后端在多 GPU 主机上使用的 Vulkan 设备索引(默认:0;环境变量 TS_GGML_VULKAN_DEVICE)。 |
--list-gpus | 列出 ggml-vulkan 可见的 Vulkan 设备(索引 + 显卡名称)后退出。 |
--port <N> · --host <address> · --urls <urls> | 监听端口(默认 5000;环境变量 PORT)、绑定地址(默认 0.0.0.0;环境变量 HOST),或以分号分隔的完整监听 URL,用于前两者无法表达的情形(回退到 ASPNETCORE_URLS;同时给出时以 --port / --host 为准)。 |
--no-webui | 不提供内置 Web UI;GET / 返回存活响应。所有 API 端点(包括 /uploads)照常可用。环境变量:TS_NO_WEBUI(非 0 即开启)。 |
--help | 打印完整参数说明后退出;不带任何参数时也会显示。推理始终需要启动参数 --model。 |
--config <path> | 从 JSON 配置文件读取参数(命令行参数会覆盖它)。支持 ${变量} 与通过 { "path": ..., "urls": [...] } 自动下载模型。可重复。 |
--max-tokens <N> | 所有端点(Web UI、Ollama、OpenAI)的生成上限:请求未指定时用它填充,请求要求更多时按它截断(默认:20000,该默认值只填充、不截断)。 |
--temperature / --top-k / --top-p / --min-p | 采样值(默认 0.8 / 40 / 0.9 / 0)。 |
--repeat-penalty / --presence-penalty / --frequency-penalty / --seed | 惩罚与随机种子(默认 1.1 / 0 / 0 / -1)。 |
--repeat-last-n <N> | 惩罚考虑最近多少个 token(默认 64;0 关闭,-1 使用全部;环境变量 TENSORSHARP_REPEAT_LAST_N)。请求中写作 repeat_last_n。CLI 使用同样的拼写;原先 CLI 独有的 --penalty-last-n 已移除,两个宿主都会拒绝它。 |
--stop <string> | 停止序列(可重复)。在 config 优先级下与逐请求的 stop 列表合并;在 request 下被其替换。 |
--sampling-precedence <config|request> | 当请求同时携带了你在上面配置过的采样参数时以谁为准:config(默认)保留你的取值,request 让客户端的取值优先。你未配置过的参数始终取请求中的值。环境变量:TENSORSHARP_SAMPLING_PRECEDENCE。 |
--continuous-batching / --no-continuous-batching | 启用(默认)或禁用迭代级分页批处理。 |
--no-prefix-cache | 关闭运行时前缀复用(Radix 前缀缓存,默认开启)、启动时对共享系统/工具提示词的预处理,以及跨次启动的持久化;它也会设置 TS_SCHED_PREFIX_CACHE=0。开启时,服务端在启动时对共享提示词预填充一次并保存结果,因此进程的第一条消息与其他消息开销相同(在一个智能体配置上实测从 21.8 秒降到 0.7 秒);代价是提示词、技能或模型变化后的首次启动要等这一步完成才开放端口。检查点位于二进制旁的 prefix-cache/<model>/,每个模型两个文件;TENSORSHARP_PREFIX_CACHE_DIR 可移动其根目录。 |
--spec / --no-spec | 启用 / 禁用投机解码(默认关闭)—— 对内嵌在主干 checkpoint 里的草稿器,这是显式的开启开关,因为加载它们会把额外权重调入显存;--spec-type ngram 也要靠它开启。默认的 auto 类型下,只在权重自带草稿器时生效 —— 对 Qwen 3.6 而言,这意味着要用保留了 NextN 块的 GGUF(例如 -MTP- 仓库);基础仓库的 GGUF 已把它剥掉,会静默退回普通解码。Qwen 3.8 27B、GLM-5.2 与 GLM-5.3 的草稿头本来就在主干 GGUF 里,没有额外文件要下载,但该参数仍必须在模型加载之前出现在命令行上:正是它让 glm-dsa 把 NextN 层调入显存(GLM-5.2 的 IQ2_XXS 下约 3 GiB),同时也挤掉了一部分上下文空间。在 --tp N>1 下它会被拒绝 —— 那时草稿块只能借用按列切分的主干 LM head —— 因此这两个 GLM 版本上的投机只在单设备或显式 --layer-split N 放置模式(不启用张量并行)下生效。Nemotron-H 拒绝一切投机方式:在 --spec 下它按普通解码服务,并提示一次。→ MTP |
--spec-type <name> | 投机算法:auto(默认)使用权重自带的草稿器;draft-head 与 block 显式钉住其中之一;ngram 不需要训练权重,靠在上下文中做后缀匹配来起草。但它仍需要主干支持投机验证,因此无法在 GPT-OSS、Mistral 3 与 Hunyuan Dense 上运行;DeepSeek V4 / V4.1 与 Muse-Glimmer 只能通过各自的块级草稿器验证,因此只有用 --draft-model 加载了该草稿器时它才会运行;而 Nemotron-H 会拒绝所有投机方式。--spec-type 只选择算法 —— 开启 n-gram 要写 --spec --spec-type ngram。若没有 --spec 或 --draft-model(且未设置 TS_SPEC),它与 --spec-draft、--spec-pmin 都不会开启投机,服务端会在启动时打印一条说明此事的 WARNING。环境变量:TS_SPEC_TYPE。 |
--spec-draft <N> | 每个推测步草拟的最大 token 数(默认 8;块级草稿器默认取其训练块大小,并会把取值压到该块大小)。 |
--spec-pmin <f> | 保留某 token 所需的最低草稿置信度;0 表示完全不设门限。默认值取决于算法:逐 token 草稿头为 0.15,块级草稿器为 0.35(后者的门限是累积前缀概率,因此同一个数字要严格得多),ngram 为 0(在那里它改为缩放所需的匹配长度)。 |
--draft-model <path> | 所有以独立文件发布的草稿器共用的 GGUF 参数 —— DeepSeek V4 的 DSpark 支持模块、Muse-Glimmer 与 Qwen 3.8 的 DFlash / DFlash2 草稿器、Gemma 4 的 gemma4-assistant 草稿头,以及 Qwen 3.8 Flash Next 的共享 MTP 头(GGML 后端)。由文件自身的 general.architecture 决定加载方式,写出这个文件本身就会启用投机 —— 不需要再加 --spec(显式的 --no-spec 可将其否决)。Qwen 3.6、Qwen 3.8 27B、GLM-5.2 与 GLM-5.3 的 NextN 都位于主干 GGUF 中,不需要此参数 —— GLM-5.3 在 blk.78 上带的是完整的一块,由 --spec 负责启用;显式草稿无法激活时启动会失败(退出码 2)——例如 --tp N > 1 下的 DFlash / DFlash2 草稿器,或 Nemotron-H 上的任何草稿器。DeepSeek V4 的 DSpark 在 cuda 与 ggml_cuda 后端上对单序列请求生效;DeepSeek V4.1 仅在 ggml_cuda / ggml_cpu 上接受 deepseek41-dspark 草稿器,这条路径属于实验性质,训练模型已在 ggml_cuda 双 GPU 按层切分下通过初步文本/图像 HTTP 检查;尚不构成通用质量或吞吐验证。每一行验证都用该请求自己的采样器,因此可与任意采样设置组合。环境变量:TS_SPEC_DRAFT_MODEL。→ DSpark |
--prefill-chunk-size <N> | 每个调度步的最大 prefill token 数(设置 TS_SCHED_PREFILL_CHUNK)。 |
--kv-cache-dtype <type> | KV 缓存精度:f32、f16、q8_0 或 q4_0(默认自动,由后端 / 模型选择;环境变量 KV_CACHE_DTYPE;q4_0 面向 128K–256K 的超长上下文)。 |
--n-cpu-moe <N|all> / -ncmoe · --cpu-moe / -cmoe · --cpu-moe-threads <N> | MoE CPU 卸载,与 CLI 相同:把前 N 层(或全部层)的路由专家留在系统内存中并在 CPU 上做乘法。所有架构默认 0。主机线程数默认:可用 CPU 不超过 2 个时为 1,不超过 8 个时为减一,更多时取一半且上限 64;DeepSeek V4 / V4.1 与 GLM-5.x 的原生执行器在卸载专家后使用全部可用 CPU(GLM-5.x 在无 GPU 的运行中也是如此)。环境变量:TS_N_CPU_MOE、TS_CPU_MOE、TS_CPU_MOE_THREADS。 |
--redis-url <url> | 用 Redis(TS_RESPONSES_STORE_REDIS_URL)而非进程内存承载 OpenAI Responses API 存储。环境中已设置的 TS_RESPONSES_STORE_REDIS_URL 保持不变。--help 把它列在“Responses API store”一节,启动日志会打印 Redis configured via --redis-url: the Responses API store uses <url>. |
--qwen-image-vae / --qwen-image-vl / --qwen-image-mmproj <path> | 覆盖解析到的 Qwen-Image-2.1 伴随文件(专用 2.1 VAE / Qwen3-VL-8B 文本编码器 / Qwen3-VL-8B mmproj)。 |
--qwen-image-variant base|turbo | DiT GGUF 是哪一个 Qwen-Image-2.1 检查点(GGUF 不带元数据)。turbo 按 Qwen-Image-2.1-Turbo 公布的 8 步调度、CFG 1 采样,拒绝其他步数,也拒绝步数蒸馏 --lora 插件。不声明时,文件名含单词 turbo 即按 Turbo 处理,加载时会说明。其他模型照常加载、不使用它,并记录一条警告。环境变量:TS_QWEN_IMAGE_VARIANT。 |
--lora <path> / --lora-scale <f> / --lora-config <path> | 所托管的 Qwen-Image-2.1 或 MiniMax-H3(FL2VA)模型的 LoRA 插件,拼写与绑定规则都与 CLI 相同(重复 --lora 可叠加 Qwen-Image-2.1 插件;强度与配置绑定到前一个 --lora)。启动时检查,启动模型不接受的插件会在插件下载之前被拒绝(--config 仍需下载的模型在该下载完成后立即检查);之后加载的模型若不接受这些插件,就不带它们运行,并记录一条点名它们的警告。应用到每个图像请求或视频片段;尚未实现按请求选择 LoRA。在 Qwen-Image-2.1 上,请求中的 steps / cfg 仍会覆盖插件的采样配方;MiniMax-H3 Turbo 插件则把 --video-steps 以及请求中的 steps、flowShift 与 sampler 锁定为它的配方。→ Qwen-Image-2.1 插件 · MiniMax-H3 Turbo |
--width <px> / --height <px> | 图像请求既未给出尺寸也未给出面积时(所有 Web UI 请求都是如此)Qwen-Image-2.1 的默认输出尺寸(设置 TS_QWEN_IMAGE_WIDTH / TS_QWEN_IMAGE_HEIGHT);请求自带尺寸或目标面积时保留它自己的几何设置。默认尺寸需要两个值:不在 32 像素网格上的值会向下取整到 32 的倍数(最小 32),并警告一次;只设一边(或值无法解析、为负数)时默认尺寸会被忽略并警告一次,继续使用自动尺寸(2048×2048 面积)。Qwen-Image 服务端在这两种情况下都会在启动时警告,但不会拒绝启动。这两个参数同时也是 --video-width / --video-height 的别名。 LTX 2.5 默认 1024×1024,宽高必须为 64 倍数。 |
--qwen-image-lora · --offload-cpu | 已移除,启动时(包括作为 --config 键时)会直接拒绝。两者只服务于早期的 Qwen-Image-Edit 流水线。--qwen-image-lora 由 --lora 取代;--offload-cpu 没有替代参数,因为 Qwen-Image-2.1 的 DiT 权重始终常驻。 |
--penalty-last-n | 已移除,启动时(包括作为 --config 键时)会直接拒绝(退出码 1)。它是 CLI 独有的重复惩罚窗口名:请改用 --repeat-last-n <N>。 |
--paged-kv* · --paged-bench* · --paged-batching | 已移除,启动时(包括作为 --config 键时)会直接拒绝(退出码 1)。它们配置的独立分页 KV 存储已删除:跨请求的提示词复用由 radix 前缀缓存提供(--no-prefix-cache),它的 TS_KV_* 变量同样会被拒绝。--paged-batching / --no-paged-batching 是 --continuous-batching / --no-continuous-batching 的第二种拼写。 |
--video-width <px> / --video-height <px> | 请求未带 width/height 时的默认输出尺寸。视频最主要的画质杠杆,因为网页界面自己不发送尺寸。MiniMax-H3 建议两个都不设:文生视频与参考为 640×384,i2v/fl2v 采用第一个关键帧的 768p 配方尺寸(3:2 照片为 1152×768),远景人物的脸需要这个尺寸。两个都设会对所有模式(包括关键帧)固定同一尺寸;只给出宽高之一时 H3 会按条件图像的宽高比推出另一个。别名:--width / --height(它们同时设置 Qwen-Image-2.1 的默认尺寸)。 LTX 2.5 默认 1024×1024,宽高必须为 64 倍数。 |
--video-steps <N> | 请求未带 steps 时的默认去噪步数。MiniMax-H3 默认 20 步;16–24 步明显更干净,超过约 30 步收益很小。想让 MiniMax-H3 少跑几步,请改用 --lora 加载 Turbo 插件:它只按蒸馏时的 8 或 4 步采样,所以此参数应不设或设为该步数;其他取值会在启动时被拒绝,请求自带的 steps 同样如此。 LTX 2.5 只接受第一阶段固定 8 步,再自动精修 3 步。 |
--video-mode <mode> | 请求未带 videoMode 时的默认条件模式:t2v、i2v、fl2v 或 ref。不传它,每个请求会按自身携带的内容推断模式,通常这才是你想要的。 |
--video-frames <N> | 请求未带 frames 时的默认输出帧数,会对齐到模型自身的时间网格(Wan 为 4k+1,MiniMax-H3 为 17k+5)。模型默认 33,Wan2.2-TI2V 为 49,MiniMax-H3 为 22。请求值会覆盖它 —— 这是默认值,不是上限。 LTX 2.5 默认 17 帧/24 fps,帧数必须遵循 8k+1。 |
--fps <N> | 请求未带 fps 时的默认 MP4 播放帧率。模型默认 16,Wan2.2-TI2V 为 24。以固定帧率训练的模型(MiniMax-H3,24 fps)会覆盖任何其他取值。fps 只改变播放速度,不改变生成的计算量。 |
--video-vae <path> | 视频 VAE —— wan_2.1_vae.safetensors,TI2V-5B 用 Wan2.2_VAE.safetensors,MiniMax-H3 用 minimax_h3_video_vae_fp16.safetensors。默认在 DiT 同目录扫描,包含 VAE/ 子目录。环境变量:TS_VIDEO_VAE。 |
--video-text-encoder <path> | 文本编码器 GGUF —— Wan 用 UMT5-XXL,MiniMax-H3 用 Qwen3-VL-32B。默认在同目录扫描(环境变量 TS_VIDEO_TEXT_ENCODER)。当 Wan 2.2 A14B 的两个专家不在一起时,用 --video-dit2 / TS_VIDEO_DIT2 指定第二个 high/low noise 专家。 |
--audio-vae <path> | 与视频联合生成音轨的模型所用的音频 VAE(minimax_h3_audio_vae_fp32.safetensors)。不传它这类模型照样能跑并产出视频,只是没有声音。环境变量:TS_VIDEO_AUDIO_VAE。 |
--video-upscaler <path> | 两阶段视频模型所用的 2 倍潜变量放大器:LTX 2.5 先以输出尺寸的一半生成,再用 ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors 放大潜变量,最后以完整尺寸精修。默认:模型同目录的 latent_upscale_models/。环境变量:TS_VIDEO_UPSCALER。 |
--video-diffusion-vae <path> | 可选的 LTX 2.5 扩散视频解码器(ltx-2.5-video-vae-bf16.safetensors):颗粒和闪烁更少、画面更干净,但比默认的卷积 --video-vae 更柔和。仅支持 MLX 和 CPU;CUDA 会拒绝。默认:关闭。环境变量:TS_VIDEO_DIFFUSION_VAE。 |
--upload-max-mb <N> | 客户端写入的单文件上限(MB):multipart /api/upload 文件,以及从聊天请求中解码出的 base64 附件(默认 500;环境变量 TS_UPLOAD_MAX_MB)。POST /api/upload 的请求体上限跟随该值且不低于 500 MB,因此调大上限就能在那里上传更大的文件,之后按路径引用。其他路由保持 500 MB 的请求体上限;base64 编码会让文件增大约三分之一,所以 JSON 请求中的附件无论上限多大,最多约 375 MB。 |
--upload-quota-mb <N> | 上传目录的总预算(MB),生成的图像与视频也计入;会超出预算的请求在任何模型计算之前就被拒绝。默认关闭;环境变量 TS_UPLOAD_QUOTA_MB。 |
--upload-ttl-hours <N> | 删除上传目录中早于这么多小时的文件(允许小数)。默认关闭,因为聊天会话按路径引用附件;服务可被不可信客户端访问时请开启。环境变量:TS_UPLOAD_TTL_HOURS。目录默认为二进制旁的 uploads/,可用 TENSORSHARP_UPLOAD_DIR 移动。 |
--skills-dir · --skill · --list-skills · --no-skills · --skills-no-discovery · --skills-allow-exec · --skills-sandbox · --skills-allow-network · --skills-max-rounds | Agent Skills,拼写、默认值与环境变量都与 CLI 相同(默认根目录:从工作目录向上直到 Git 根目录的每个 .agents/skills,再加上二进制旁的 skills/)。在服务端,二进制旁的 skills/(POST /api/skills 安装上传技能的位置)总是最先扫描,即使指定了根目录也是如此,因此同名时它胜出;显式根目录与 TS_SKILLS_DIR 只替换 .agents/skills 默认值。同样在服务端,--skill 为每个请求选中技能,除非请求自己指定了技能;上传的技能落在二进制旁的 skills/;--no-skills 时不映射 /v1/skills 与 /api/skills,指定了技能的请求会得到 HTTP 400。 |
--code-exec 及其 --code-exec-* 选项 | 内置代码工具及其安装、网络、超时、输出、shell、温度与隔离设置,拼写与默认值都与 CLI 相同。--code-exec-languages 已移除,启动时会被拒绝。 |
--no-multi-agent | 关闭子智能体委派;它对支持工具的家族默认开启(见上文)。环境变量:把 TS_NO_MULTI_AGENT 设为 0 以外的任意值。 |
--agents-max-concurrent · --agents-max-count · --agents-max-depth | 请求树中同时活跃的后代数,不含根(默认 3,范围 1–32)· 每棵请求树创建的子智能体数(8,1–128)· 根以下的委派深度(2,1–8)。 |
--agents-max-rounds · --agents-max-generations · --agents-timeout · --agents-max-result-chars | 每个子智能体每轮的工具回合数(默认 8,范围 1–64)· 整个请求共享的子智能体生成次数(48,1–1024)· 每次子智能体运行的秒数(180,1–3600)· 每份子智能体报告的字符数(8000,256–64000)。 |
--agents-allow-worker-tools | 允许 worker 子智能体使用父智能体已启用的可写工具。默认关闭;explorer 与 reviewer 子智能体始终只读。 |
逐请求字段(temperature、top_p、seed、stop ……)会填补所有你未在此配置的参数;对于你配置过的参数,除非以 --sampling-precedence request 启动,否则以你的取值为准。chat.start 日志会打印每个请求实际使用的采样参数。
环境变量
环境变量、默认值与状态目录
| 变量 | 说明 |
|---|---|
BACKEND | 未传 --backend 时的默认后端(默认:macOS 上为 ggml_metal,其他平台为 ggml_cpu)。 |
MAX_TOKENS | 默认最大生成长度(默认:20000)。 |
MAX_CONTEXT | 硬性的上下文上限。不设时,自报的上下文只是上界:权重加载完之后引擎会去问各设备实际还剩多少显存,按「缓存加一整个 n_ubatch 计算图」能装下的大小定上下文,并打印它的选择(GLM-5.2 在 3× RTX PRO 6000 上:按层切分 342,272 token,--tp 3 91,136,--n-cpu-moe 30 646,400)。设了它,放得下就照办,放不下会带着数字直接报错,而不会被悄悄缩小。 |
TS_PDF_MAX_PAGES | 上传 PDF 时读取的页数上限,文本提取与页面图像渲染均遵循(默认:0 = 全部页面;CLI --pdf 同样遵循)。 |
VIDEO_SAMPLE_FPS / VIDEO_MAX_FRAMES | 每秒视频采样的帧数 / 可选的抽帧上限。 |
TS_FUSED_QKNORM_ROPE | Direct cuda 后端上 Qwen 3.5/3.6 文本 prefill 的融合 QK-Norm + RoPE CUDA 内核(默认开启;0 关闭)。 |
TENSORSHARP_TEMPERATURE、…_TOP_K、…_TOP_P、…_MIN_P | 当参数与请求体都未设置时的默认采样值。 |
TENSORSHARP_REPEAT_PENALTY、…_REPEAT_LAST_N、…_PRESENCE_PENALTY、…_FREQUENCY_PENALTY、…_SEED | 默认惩罚、惩罚窗口与随机种子。 |
TENSORSHARP_LOG_LEVEL / …_LOG_DIR / …_LOG_FILE | 日志级别、目录与文件开关 —— 这是配置服务端日志的唯一方式,服务端没有 --log-* 参数(CLI 也会遵循它们,作为自身参数的默认值)。 |
TENSORSHARP_PREFIX_CACHE_DIR | 服务端持久化前缀检查点的根目录(默认为二进制旁的 prefix-cache/);每个模型各有一个子目录。见 --no-prefix-cache。 |
TENSORSHARP_UPLOAD_DIR | 上传目录(默认为二进制旁的 uploads/),通过 /uploads/ 对外提供。 |
DIFFUSION_STEPS / DIFFUSION_MAX_BATCH | DiffusionGemma 每块去噪步数 / 批处理的最大并发扩散请求数。 |
TENSORSHARP_TP_DEGREE | 本地张量并行度,等价于 --tp N,仅用于层内权重切分。 |
TENSORSHARP_LAYER_SPLIT_DEGREE | 本地按层切分的 GPU 数,等价于 --layer-split N,与张量并行参数互斥。 |
TENSORSHARP_TP_DEVICES | 各 TP rank 使用的 GPU 序号,例如 0,2(默认 0..tp-1)。用于 GGML 后端。 |
TENSORSHARP_TP_NODE_ID / TENSORSHARP_TP_PEERS | 把张量并行扩展到多台机器:本节点的 0 起始编号,以及所有节点共用的逗号分隔 host:port 列表(也可用 --tp-node-id / --tp-peers)。两者必须同时设置。服务端只能是节点 0(对外提供 HTTP 的 driver);其余节点运行 TensorSharp.Cli worker。 |
TS_RESPONSES_STORE_REDIS_URL | 用 Redis 而非进程内存承载 OpenAI Responses API 存储。服务端参数:--redis-url。 |
服务器默认监听 http://0.0.0.0:5000;--port、--host 与 --urls(或环境变量 PORT / HOST / ASPNETCORE_URLS)可以改变它,Docker Space 镜像设置的是 PORT=7860。
连续批处理调参
连续批处理与调度器参数
调度器 / 引擎的旋钮在进程启动时读取。通过环境变量(或会被翻译成它们的 --continuous-batching 系列参数)设置。
| 变量 | 说明 |
|---|---|
TS_SCHED_DISABLE_BATCHED | 1 强制逐序列 KV 交换,即使模型支持批处理(= --no-continuous-batching)。 |
TS_SCHED_MAX_BATCHED_TOKENS | 每步 token 预算(默认 4096)。 |
TS_SCHED_MAX_RUNNING_SEQS | 最大在飞序列数(默认 16)。 |
TS_SCHED_PREFILL_CHUNK | 存在活跃 decode 时每请求的 prefill 上限(默认 256);仅 prefill 时会用满完整 token 预算。 |
TS_SCHED_SOLO_PREFILL_CHUNK | 系统中最多一个序列时的 prefill 分块大小,会限制所有独占 prefill 分块(默认 8192,受 TS_SCHED_MAX_BATCHED_TOKENS 约束)。不设置时,能自行决定单独提示步长的模型会自己决定:开启流水线 prefill 的 Muse Spark 使用 8192 token 的步长,不超过 2048 token 的余数并入前一步,可能超过该预算。设置它则关闭模型自定的步长;引擎日志会说明实际采用哪一种。 |
TS_SCHED_DECODE_QUANTUM | 切换序列前的 decode token 数(默认 256 = 块大小)。 |
TS_SCHED_NUM_BLOCKS / TS_SCHED_BLOCK_SIZE | 引擎池中的物理块数(默认 256) / 每块 token 数(只靠整页复用的家族默认 16,其余默认 256)。 |
TS_SCHED_PREFIX_CACHE | 0 禁用所有跨请求的运行时前缀复用(= --no-prefix-cache 所设置的值)。 |
TS_BATCHED_FUSED_DECODE | 原生槽位路径(DeepSeek V4、GLM 5.x)默认启用批处理融合解码:一张图、每个序列一个 token,整批只读一次权重——GLM-5.2 在 4 路并发下总解码吞吐 1.81 倍。设为 0 可切回串行融合 decode。批处理会改变 GEMM 形状,而 2-bit MoE 可能把这点差异放大成不同的专家选择。 |